

Cuanto más avanzan las redes neuronales, más relevante se vuelve trabajar con UBT. Si antes había que hacer malabares para hacer único un video ajeno, ahora puedes crear tus propios clips literalmente en minutos. Y el resultado está muy lejos de lo que era hace 2–3 años.
Esto es especialmente relevante en el contexto de los clips para Reels. La práctica demuestra que todavía hay una gran audiencia masculina dispuesta a ver videos de chicas atractivas e interactuar con ellos.
Por qué crear Reels para Instagram
Según las estadísticas, la audiencia principal de Instagram tiene entre 18 y 44 años.
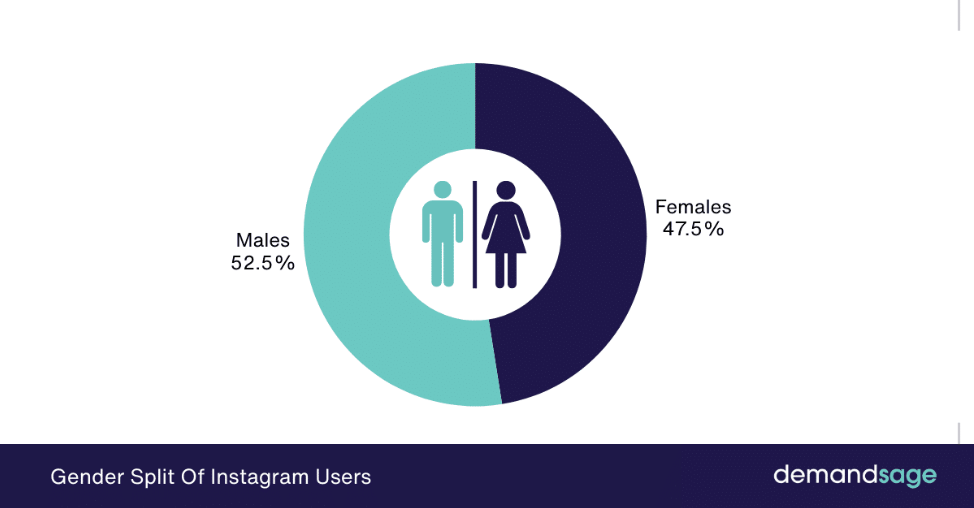
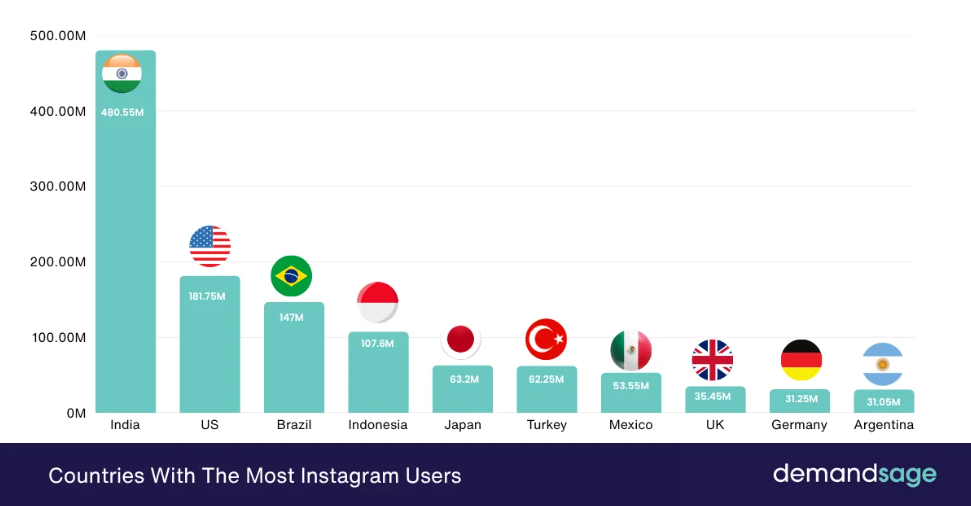
Quienes no están familiarizados con el source dirán que la mayor parte de este tráfico son estadounidenses. Pero las estadísticas no opinan lo mismo.
Ahora vamos a lo principal: ¿por qué probar este source? Para responder a esta pregunta, te proponemos ver una captura de pantalla de los Reels de un perfil de chica.
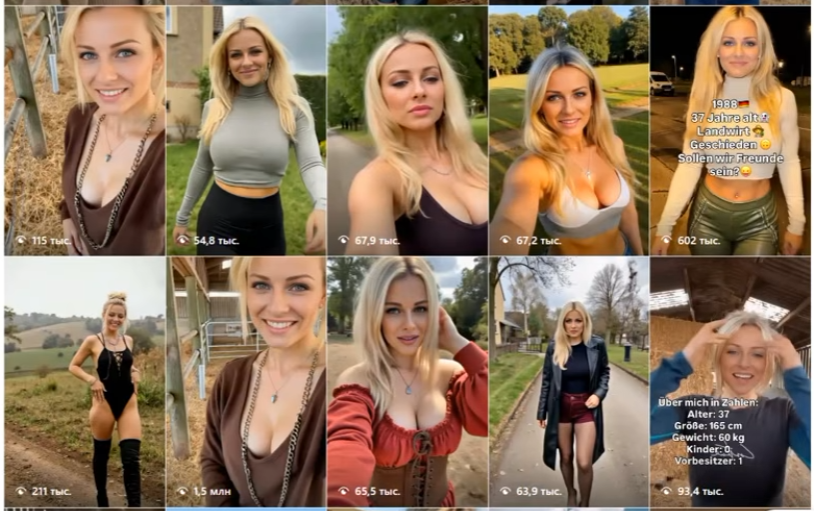
No es difícil notar que se trata de un modelo generado por IA. Incluso un principiante puede crear uno así. Pero aun así, las chicas generadas pueden dar buenos resultados.
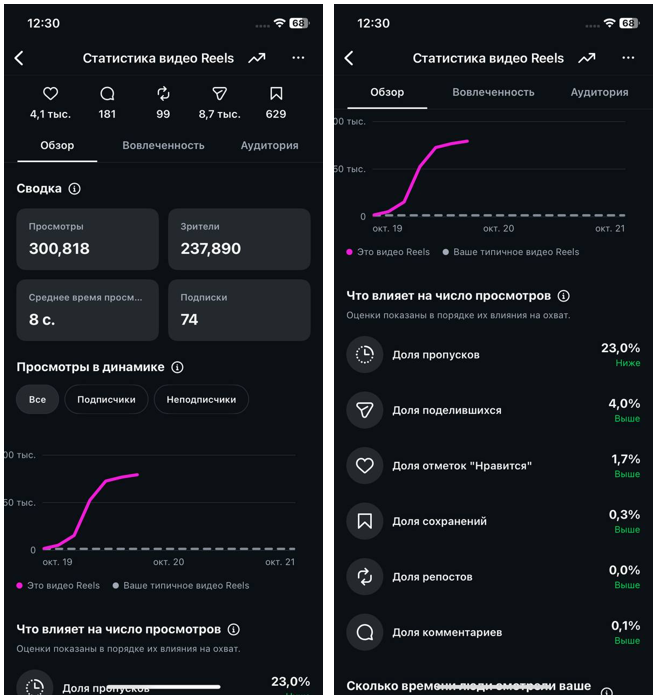
Para quienes no estén listos para probar diferentes tipos de modelos, descartar decenas de generaciones y obtener tráfico de la nada, probablemente este material no será interesante. Para todos los demás, construiremos el artículo en torno a la práctica: cómo generar estos Reels paso a paso, qué servicios usar y cuánto cuesta todo esto. Tradicionalmente, analizaremos dos opciones: una casi gratuita y otra de pago.
Cómo crear Reels con redes neuronales
En resumen, el proceso se ve así:
Encontramos una chica atractiva o la creamos desde cero → conseguimos un video donante → cambiamos el rostro.
En la práctica, hay muchos matices, de los que hablaremos con más detalle.
Desglosamos todo el proceso paso a paso
El primer paso es crear la chica. Después de eso, o hacemos un video único, o modificamos uno ajeno insertando a nuestra modelo. Veamos esto en detalle.
Buscamos o creamos la modelo
Primero necesitamos una chica que promocione el offer. La peor opción es tomar fotos de alguna influencer que ya tenga un perfil activo en Instagram. El sistema detectará rápidamente el contenido no original y no dará mucho alcance. Es mucho más efectivo tomar imágenes de plataformas especializadas o crearlas tú mismo.
Gratis. Entramos en Pinterest y escribimos en la barra de búsqueda palabras clave, por ejemplo, girl. Si no especificas el tipo de modelo, aparecerá de todo: desde asiáticas delgadas hasta eslavas de busto grande.
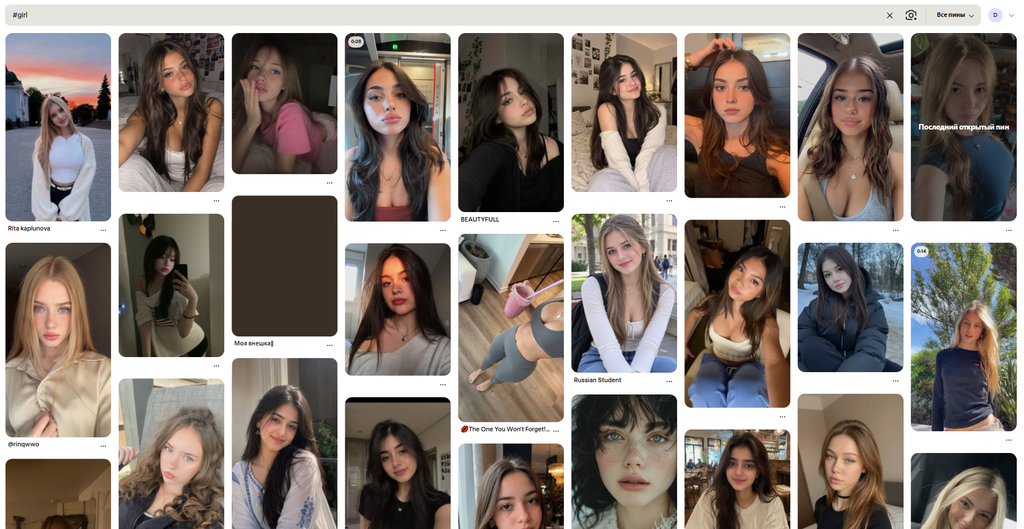
Este método es ideal para empezar porque cuesta 0 dólares. Sin embargo, su desventaja es la siguiente: para tomar el rostro de la modelo encontrada, necesitamos de 10 a 20 referencias de ella. Es preferible que sean imágenes similares a las que se usan en el video donante. Por ejemplo, si en el video donante la protagonista aparece en primer plano contando algo, las referencias deben ser fotos de la cara desde diferentes ángulos, con distintas luces y emociones. Si en el clip la chica baila, se necesitan ejemplos de la modelo en diferentes poses y posiciones, etc. A veces encuentras una apariencia interesante en Pinterest, pero no logras encontrar más fotos de esa chica. Esto afecta la calidad final del video.
Condicionalmente gratis. En esta opción, tomamos las fotos seleccionadas y las llevamos a un Gemini o ChatGPT hipotético. Por ejemplo, ChatGPT no menciona límites explícitos: seguirá generando fotos hasta que el servidor se sobrecargue. En la red bromean que la sobrecarga ocurre cuando los vibe coders en EE. UU. se despiertan. El modelo NanoBanana2 Lite funciona gratis, pero no siempre con buena calidad. Es más fácil comprar una suscripción y no complicarse la vida.
Independientemente del escenario elegido, subimos los referentes para clonarlos o para describirlos con el fin de generar algo único posteriormente.
Primero le pediremos a ChatGPT que muestre cómo se vería la chica del referente desde diferentes ángulos.
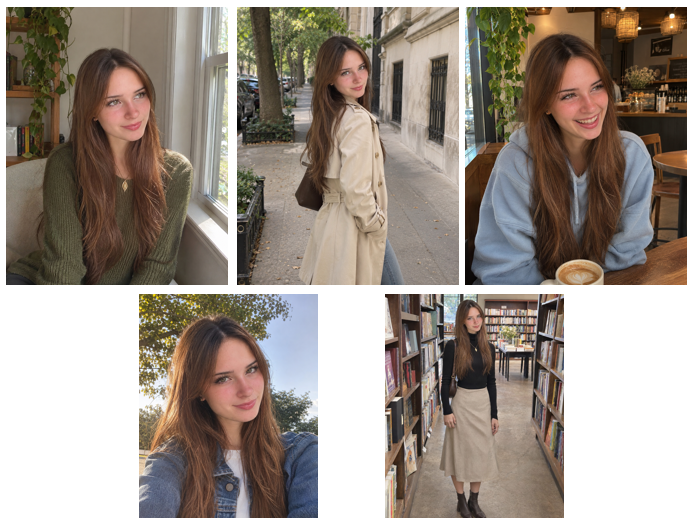
Lo mismo, pero con NanoBanana2 Lite.
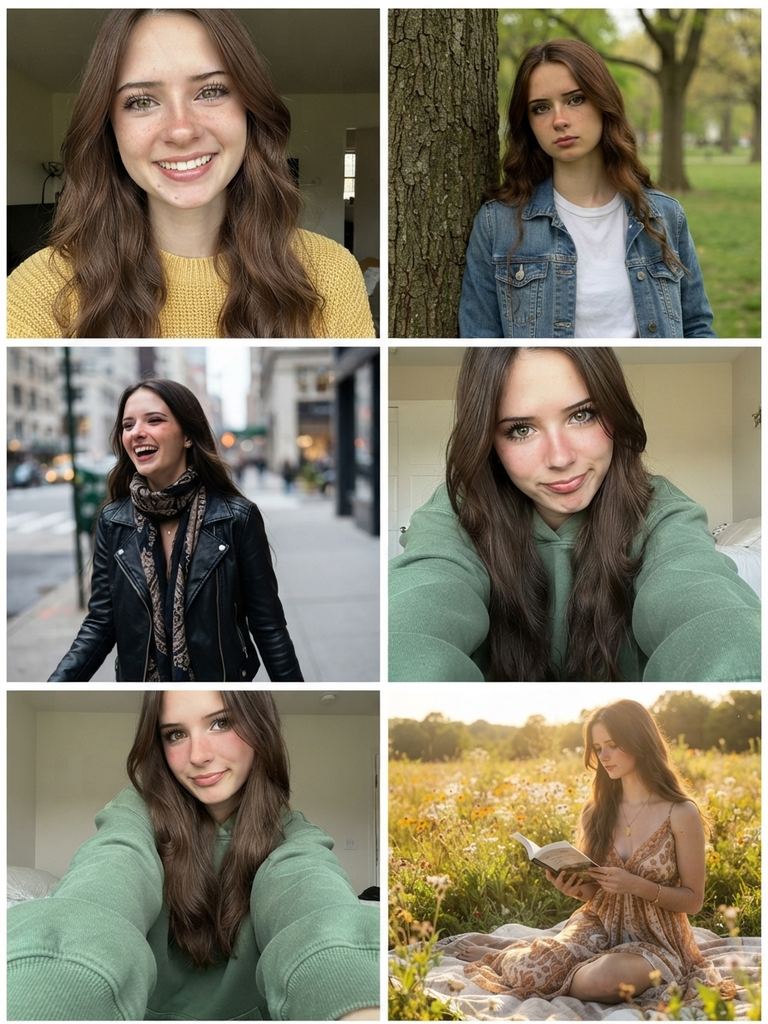
Ahora le damos un conjunto de fotos originales de una chica real y le pedimos que cree su gemela, que nunca ha existido. Esto es lo que logró ChatGPT:
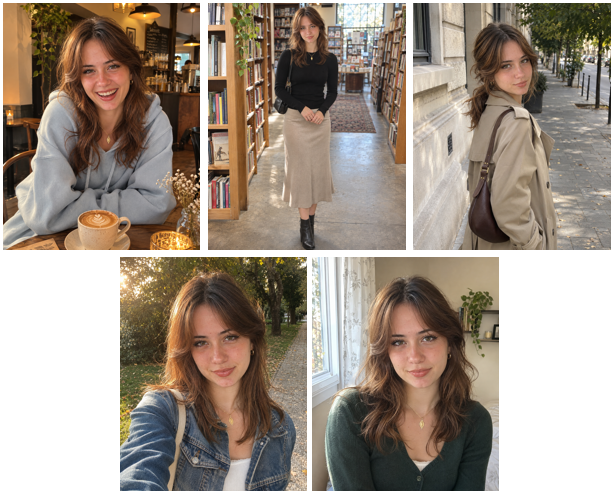
Y aquí el resultado de NanoBanana 2 Lite:
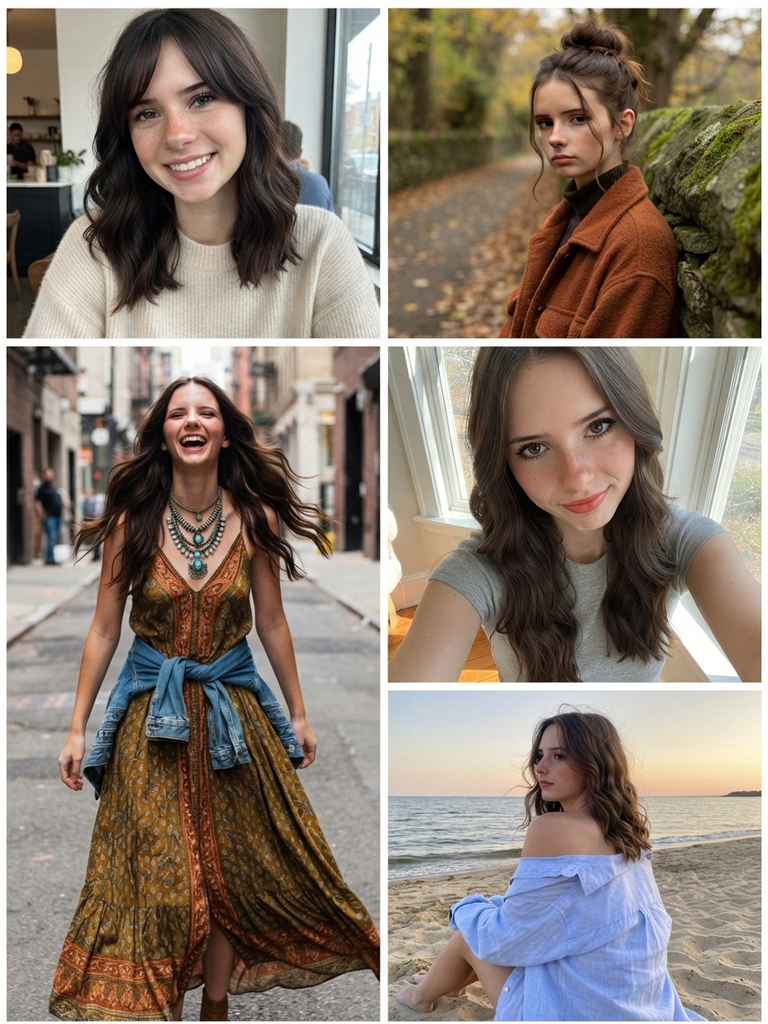
Tanto la primera como la segunda chica son únicas. Si se desea, se puede editar su apariencia directamente en el chat, pero para esta tarea es más óptimo usar NanoBanana en Google AI Studio: es gratuito y es difícil agotar su cuota incluso trabajando todo el día. Tomemos una foto al azar y cambiemos el peinado.
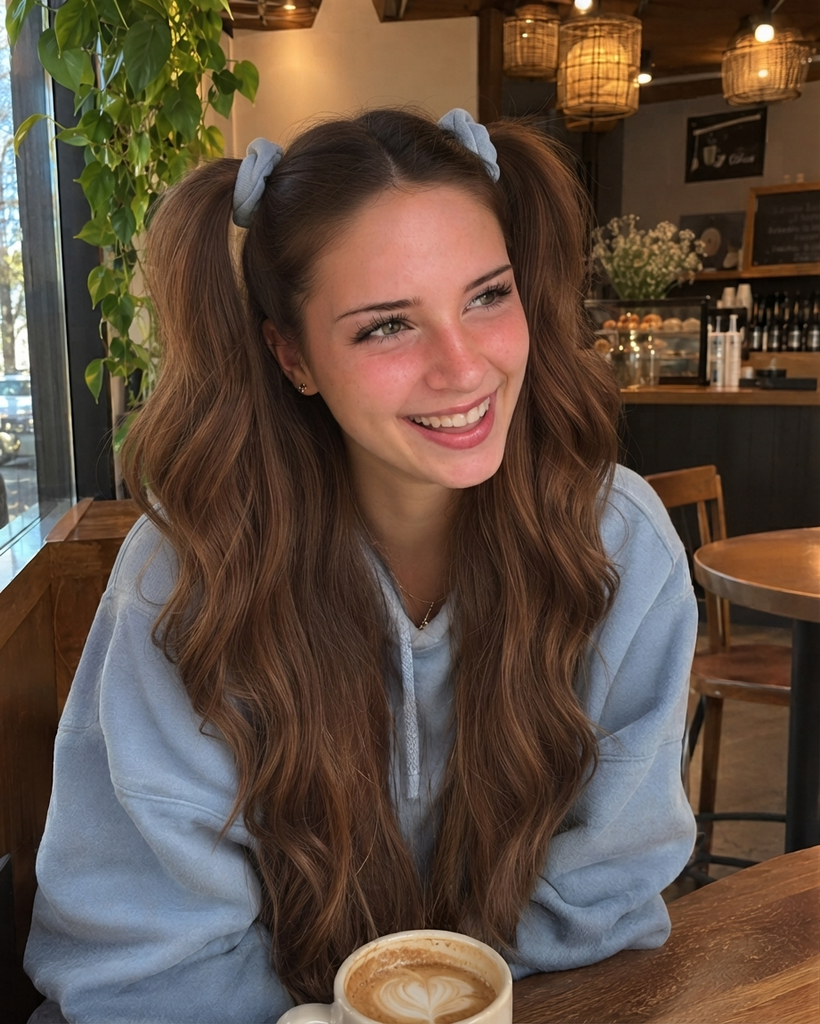
Que esta chica siga siendo nuestra modelo.
Generamos video
Si el presupuesto lo permite, es más rentable crear videos según tu propio guion. A menudo requiere varias generaciones (a menudo de $3-4 cada una para que se vea natural), pero el contenido final es original. Por eso también logra mayor alcance. Sin embargo, no todos los LLM querrán, por ejemplo, crear chicas desnudas bailando. Pero para nichos white, es la opción ideal. Un enfoque alternativo es modificar videos ya hechos. Con estos existe el riesgo de shadowban, pero también cuestan muy poco.
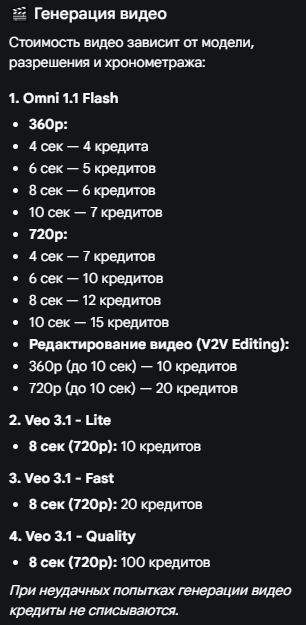
Primero, veamos cómo generar. Para probarlo tú mismo, compra una suscripción Pro en Google Flow y obtén 1050 créditos al mes. Esto alcanza para unas 60-70 generaciones. Las cuentas nuevas tienen descuento: durante 3 meses costará $4,99, luego $20. Así, por $20 y 4 suscripciones en los primeros 3 meses, obtienes 240 videos al mes.
Omni 1.1 es el mejor modelo de Google en cuanto a velocidad y calidad de generación al momento de la publicación. Puede crear no solo video, sino también audio. Sin embargo, esto no siempre funciona: varias veces el modelo detuvo la generación y devolvió los créditos por problemas al crear audio.
Primero, una prueba rápida: subimos nuestra modelo a Google AI Studio, añadimos en el chat el logo de un Tinder hipotético y pedimos que lo sostenga en la mano en su teléfono. Salió bastante bien a la primera.
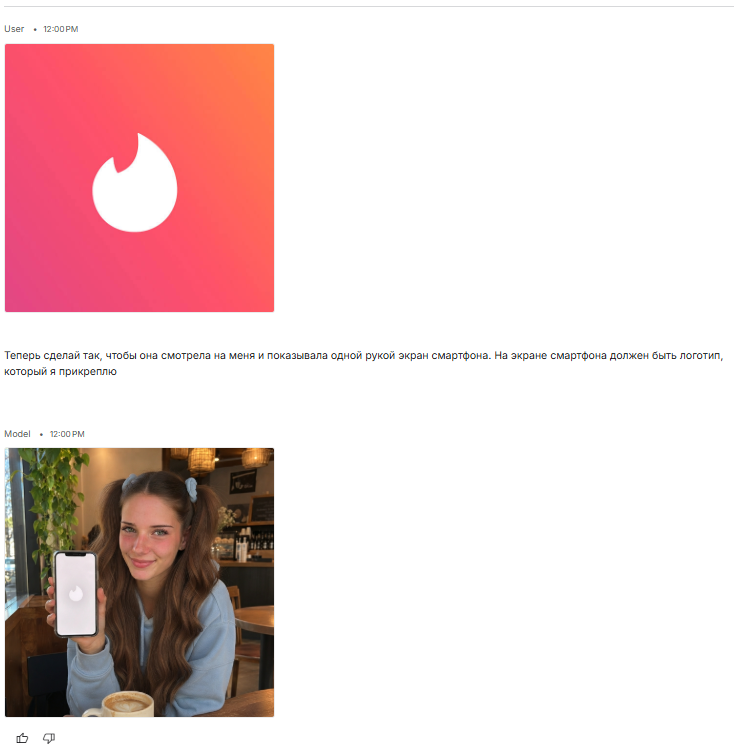
Ahora subimos ambos referentes a Google Flow y tomamos el prompt de ChatGPT para generar el video.
| Create a 10-second ultra-realistic vertical 9:16 UGC dating app advertisement using the two provided reference images. REFERENCE IMAGES: Image 1 is the exact STARTING FRAME. Image 2 is the exact ENDING FRAME. CHARACTER CONSISTENCY:The woman in both images is the same person. Preserve her exact facial identity, facial proportions, green-hazel eyes, natural skin texture, long chestnut-brown hair styled in two high ponytails with pale blue scrunchies, light blue oversized hoodie, and subtle makeup. No changes to her face, hairstyle, age, outfit, or accessories. SCENE:A cozy coffee shop with warm pendant lighting, wooden furniture, leafy plants, and a cup of latte on the table. Natural smartphone footage, authentic casual UGC aesthetic. TIMELINE: 0–2 seconds:Start exactly as shown in Image 1. The woman smiles warmly while looking slightly to the side. She slowly lowers her eyes toward the coffee cup, giving a small, shy smile. She then looks back toward the camera with a playful, slightly flirtatious expression. 2–7 seconds:She makes direct eye contact with the camera, tilts her head slightly, and speaks in Russian with a soft, natural, youthful female voice. Exact spoken dialogue in Russian: «Привет… Ты мне понравился. Может, познакомимся поближе?» She speaks with a playful, slightly shy intonation, as if flirting with someone sitting across the table. Include a tiny pause after «Привет». Her lips must synchronize accurately with every Russian word. Her expressions remain subtle, human, and believable. 7–10 seconds:After speaking, she smiles mischievously, briefly glances down, reaches for her smartphone from below the frame, and naturally raises it toward the camera. She turns the smartphone screen outward and presents it clearly to the viewer. The phone display must show exactly the same application logo, icon, colors, and screen layout as in Image 2. The screen must be clearly visible, sharp, and stable. Finish with the exact composition of Image 2. She holds the phone next to her face and smiles at the camera. CAMERA AND MOTION:One continuous shot, no cuts, no transitions, no camera jumps. Mostly static camera positioned across the table at eye level, with subtle natural handheld movement. Realistic head motion, natural blinking, accurate finger anatomy, realistic hand-to-phone interaction, physically believable hair movement. AUDIO:Natural Russian female speech with perfect lip synchronization. Soft background coffee shop ambience. No music, no narration, no other voices. STYLE:Photorealistic smartphone video. Authentic TikTok / Instagram Reels UGC advertisement. Natural facial expressions, realistic skin pores and imperfections, subtle lighting variations. Not cinematic, not overly polished, not artificial. STRICT CONSTRAINTS:No facial morphing, no identity drift, no hairstyle changes, no extra fingers, no distorted phone, no changing the application logo, no subtitles, no text overlays, no watermarks, no exaggerated gestures. The video must appear as a genuine, spontaneous recording of a real woman casually flirting with the viewer in a coffee shop. |
Por 15 créditos y 1,5 minutos, el modelo genera este resultado. Google Flow solo entrega fragmentos de 10 segundos. Por eso, es mejor dividir los videos largos en partes lógicas y unirlas después.
Cambiando un video ajeno
No existe una fuente universal con videos listos, pero sí hay tres plataformas más obvias: Pinterest, YouTube y el propio Instagram. El formato del video depende de la idea. Algunos querrán hacer creativos con bailes, otros simplemente lip sync. Vamos a probar dos formatos: cabeza parlante y bailes. Encontramos ambos videos fuente en YouTube Shorts, puedes verlos aquí y aquí.
Vamos a generar el baile. Para ello, creamos el primer lote de imágenes de referencia del mismo tipo que el video fuente. Por ejemplo, si en el original la modelo aparece de cuerpo entero, necesitamos referencias de cuerpo entero. Si es de medio cuerpo, entonces de medio cuerpo.
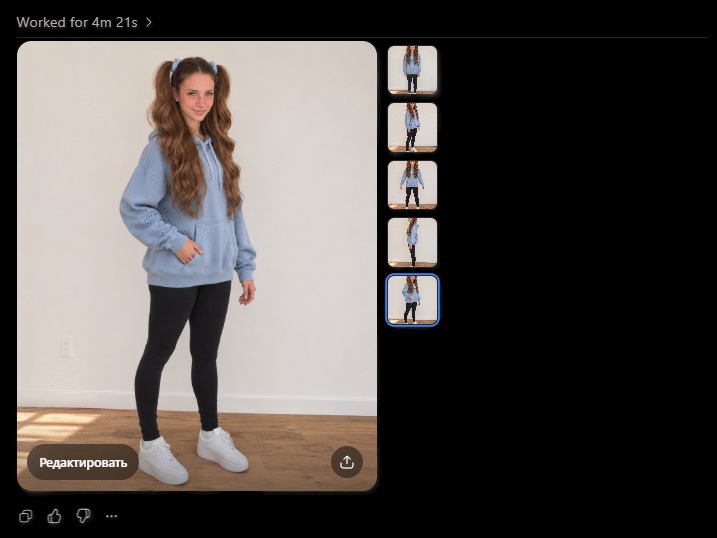
Ahora tomamos el prompt del mismo ChatGPT:
| Create a realistic vertical 9:16 video using the uploaded materials. INPUT MATERIAL ROLES: — Reference Images 1–5 are identity and body reference images of the target girl. — The uploaded video is the motion and choreography reference. GOAL: Generate a new video where the girl from Reference Images 1–5 performs the same dance as in the reference video. CHARACTER IDENTITY: Use the girl from the reference images as the main subject. Preserve her exact recognizable identity: — young woman — fair skin — green-hazel eyes — long chestnut-brown wavy hair — hairstyle: two high ponytails with light blue scrunchies — soft natural makeup — youthful face and proportions OUTFIT: Keep the exact outfit from the reference images: — oversized light blue hoodie — black leggings — white sneakers BODY AND PROPORTIONS: Follow the body shape, height, proportions, and overall silhouette from the full-body reference images. Keep her looking like the same girl in all frames. MOTION TRANSFER: Use the uploaded reference video as the choreography source. Transfer the dance performance to the target girl as accurately as possible: — same sequence of moves — same rhythm and timing — same body sways — same steps — same arm gestures — same head movement — same playful energy The goal is not a random dance inspired by the video, but a close recreation of the same dance performance using the target girl. SCENE: Place her in a simple clean indoor space suitable for dance, similar to a casual home recording. Use a plain light wall and clear floor space. Keep the environment uncluttered so the body remains fully visible. CAMERA: — vertical 9:16 — full-body framing for most of the clip — one continuous shot — camera facing her from the front — stable smartphone-like framing — no cuts — no zoom jumps — no angle changes unless necessary to preserve the original motion feel STYLE: Photorealistic, natural smartphone video. The result should look like a real girl genuinely dancing, not like CGI. Natural lighting, realistic anatomy, realistic hair movement, realistic clothing folds. IMPORTANT CONSTRAINTS: — preserve facial identity — preserve hairstyle and hair color — preserve outfit — no identity drift — no face morphing — no extra limbs or fingers — no deformed hands — no body distortion — no random choreography changes — no scene changes — no text overlays — no subtitles — no watermark PRIORITY ORDER: 1. Keep the girl’s identity consistent with the reference images 2. Recreate the choreography and timing from the reference video 3. Maintain realistic motion, anatomy, and natural hair/clothing physics OUTPUT: A polished, realistic dance video where the reference girl performs the same dance as the motion-reference video. |
Cargamos en Google Flow el video de referencia y las fotos de nuestra belleza, insertamos el prompt. Recordamos una limitación importante: el modelo solo crea fragmentos de 10 segundos. Por eso, propone hacer o bien los segundos 0-10, o bien los 10-20. Creamos dos partes y las montamos en ChatGPT. El resultado se puede ver aquí.
Ahora la cabeza parlante. Tomamos la segunda fuente y hacemos referencias para ella.
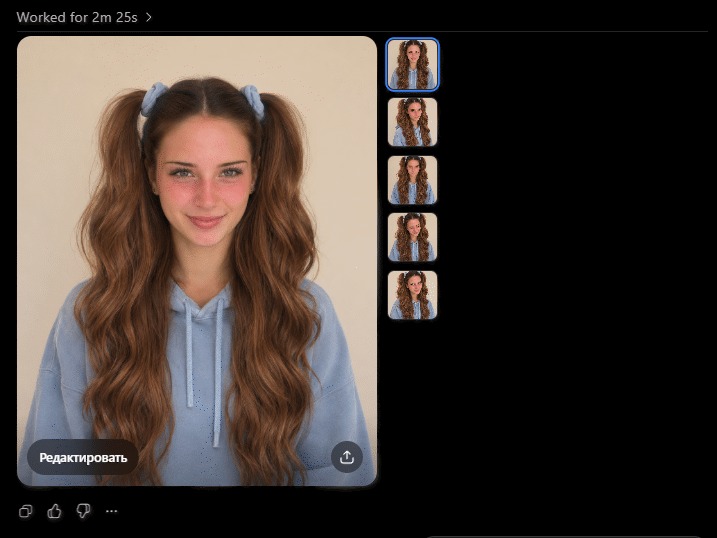
Cargamos el prompt y escribimos manualmente el texto que debe decir la chica:
| Create a highly realistic 10-second vertical 9:16 smartphone talking-head video. Use the uploaded reference images to recreate the exact identity of the brunette woman. Use the provided reference video ONLY as a guide for camera framing, speaking style, natural facial movements and overall presentation. Do not copy the original speaker’s face or voice. CHARACTER: A young adult woman with green-hazel eyes, natural rosy skin, long chestnut-brown wavy hair styled in two high ponytails with pale blue scrunchies, wearing a light blue oversized hoodie. Preserve the same recognizable face from the reference photographs throughout the entire video. SCENE: The woman is sitting indoors in front of a plain warm beige wall. Static smartphone camera at eye level. Medium close-up, showing her face, shoulders and upper chest. PERFORMANCE: She looks directly into the camera and speaks naturally in Russian, with subtle head movements, occasional blinking, realistic lip movements and restrained facial expressions. She sounds thoughtful, slightly ironic and confident. DIALOGUE IN RUSSIAN: «Если женщина говорит фразу: «Я тебя не держу, если хочешь — уходи», вам больше нечего делать с этой женщиной. Зачем вам ребенок, который из раза в раз будет вами манипулировать вместо того, чтобы строить здоровые, равные отношения?» VOICE: Generate an entirely new female Russian-speaking voice. Voice characteristics: — young adult female — natural mid-range pitch — warm, slightly low and velvety timbre — clear native Russian pronunciation — conversational delivery — confident, calm intonation — subtle emotional emphasis — no artificial or robotic speech The voice must be completely different from the original video’s speaker. Do not imitate or clone her voice. Accurate Russian lip synchronization is essential. VIDEO STYLE: Authentic casual smartphone recording, realistic skin texture, natural indoor lighting. One continuous shot. No transitions, no background music, no subtitles, no text overlays. STRICT REQUIREMENTS: Preserve facial identity. No face morphing, no hairstyle changes, no distorted mouth, no unnatural expressions, no audio glitches, no robotic speech. |
El texto debe caber en 10 segundos. Por eso la chica eliminó una palabra, pero en general salió bastante bien. Míralo aquí.
Para mantener la pureza del experimento, probaremos Wan 3.0 Prime, el modelo avanzado de Alibaba. Subimos 5 imágenes de nuestra chica, adjuntamos el video y damos un prompt seco:
| Replace the woman in video1 with the woman from image 1-5 |
A diferencia de Google Flow, Wan 3.0 Prime tardó casi 20 minutos en crear el video. Además, esta LLM fue concebida originalmente solo como API. Esto significa que no tiene una interfaz oficial como ChatGPT o Google Flow. El acceso solo es posible a través de proveedores.
El resultado de la generación puedes verlo aquí. No es la mejor opción para pruebas rápidas, pero la calidad de la mímica, en nuestra opinión, es casi indistinguible del original.
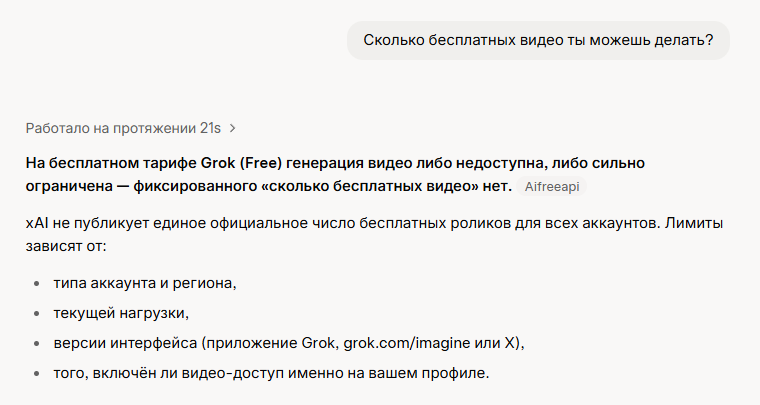
Como extra, tomamos el prompt para Flow y se lo dimos a Grok. No tenemos suscripción de pago, pero intentamos hacer un video en 480p de 6 segundos. Si quieres generar 10 segundos en mayor calidad, hay que pagar. El resultado puedes verlo aquí.
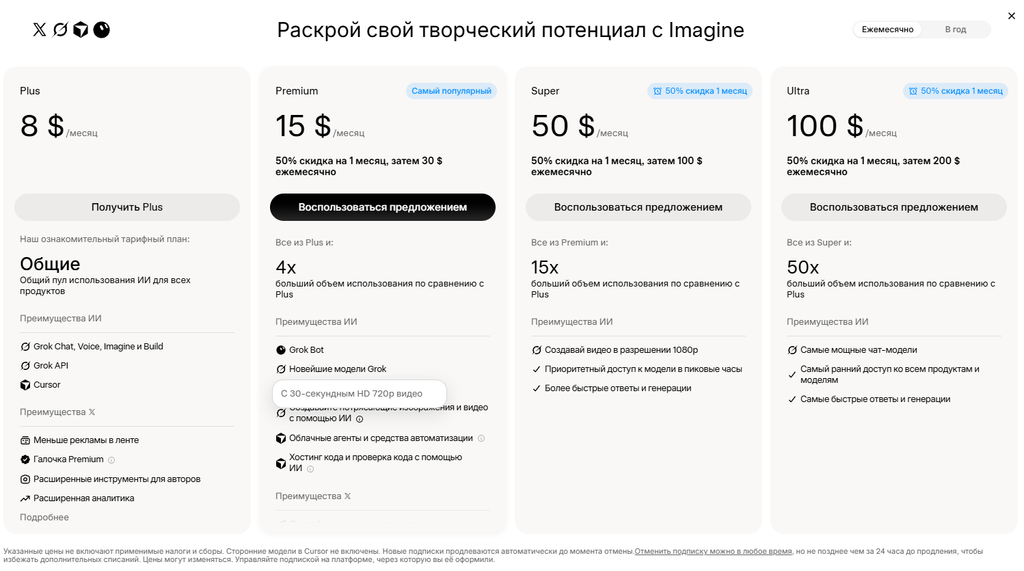
En teoría, puedes pagar una suscripción de $30 y generar hasta 30 segundos en 720p por vez. Pero, por supuesto, no lo haremos. Es curioso que el propio Grok insiste en que no se pueden crear videos en el plan gratuito.
¿Y ahora qué?
Subimos los videos listos a Reels, YouTube Shorts y otras plataformas. Si usas un video donante de Reels, es mejor no subir el clip editado al mismo Instagram. De lo contrario, corres el riesgo de un shadowban.
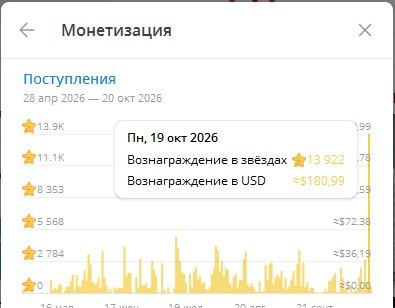
Más adelante, el contenido se puede monetizar a través de Telegram y contenido privado, o mediante ofertas externas. La experiencia de algunos especialistas muestra que esto puede ser bastante rentable.
Conclusión
Las redes neuronales han simplificado notablemente la producción de videos cortos. Ahora, para crear Reels, no es necesario contratar modelos, organizar rodajes ni pasar horas editando. Basta con algunos referentes, un buen video donante y un prompt bien formulado. Además, como demostraron nuestras pruebas, incluso las herramientas gratuitas permiten obtener resultados bastante decentes.
Sin embargo, por ahora no es posible automatizar completamente el proceso. Las redes neuronales cometen errores en los movimientos, cambian la apariencia de los personajes, no siempre manejan bien el habla y requieren repeticiones de generación. Por eso, el principal recurso aquí no es tanto el dinero para suscripciones, sino el tiempo para experimentar.
Se puede empezar con herramientas gratuitas e invertir en generadores de pago solo después de los primeros tests exitosos. Y lo más importante: no confundas el realismo del video con su efectividad. Incluso una chica perfectamente generada no garantiza por sí sola alcance ni clics. Como en cualquier otro enfoque de UBT, el resultado lo determinan una buena idea, la audiencia elegida y la comprobación sistemática de hipótesis.

Comentarios (0)