

En 2026, el SEO dejó de ser solo sobre optimizar páginas para Google o Yandex. Para obtener ganancias, ahora hay que luchar por la visibilidad del sitio en diferentes entornos: Bing, ChatGPT, Alisa, AI Overviews y otros.
Muchos especialistas en SEO piensan que las redes neuronales resolverán la optimización de búsqueda en un instante. Pero el resultado de su trabajo depende mucho de cómo piensa el propio webmaster. En este artículo analizaremos cómo crear tu propia máquina SEO, organizar el trabajo de la IA y cuánto costará aproximadamente.
Cómo es el SEO en 2026 y por qué no puedes prescindir de la IA
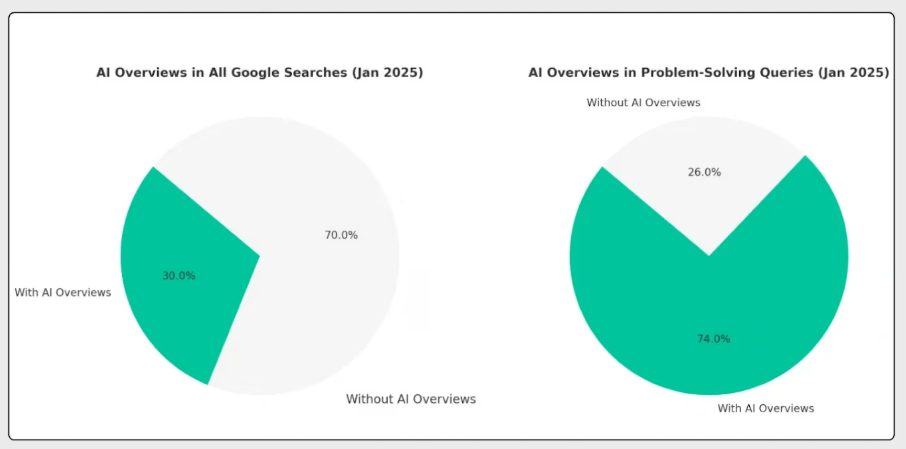
Cuando el afiliado trabajaba solo con Google o Yandex, todo era mucho más sencillo: había casos prácticos, notas de desarrolladores y foros temáticos. Ahora, limitarse solo a los buscadores clásicos ya no tiene sentido. Según datos de enero de 2025, en más de 2/3 de los casos los usuarios resuelven su problema precisamente con respuestas de IA, y no con los resultados clásicos de búsqueda.
La lógica es simple: ¿para qué revisar manualmente cientos de páginas si la red neuronal puede analizar toda la información y dar una respuesta estructurada mejor que cualquier artículo?
Esta situación obliga a los especialistas en SEO a replantear su enfoque y tener en cuenta al menos tres detalles importantes:
Los usuarios buscan información en todas partes. Antes, la búsqueda era lo más lineal posible: el usuario iba a Google o Yandex, escribía una consulta corta, abría un par de sitios y buscaba la respuesta allí. En esencia, toda la lucha era solo por posiciones en los resultados. Pero ahora ese modelo ya no sirve para trabajar. El usuario puede hacer una pregunta en ChatGPT y recibir una respuesta lista sin entrar a ningún sitio, o puede ir a YouTube y ver un video. Además, parte de los leads seguramente usará un asistente de voz y resolverá su problema en zero-click.
Las keywords ya no son prioridad. Antes de la llegada de la IA, una de las tareas principales de cualquier especialista en SEO era crear briefs detallados para los textos, indicando el número de repeticiones necesarias. Durante muchos años este enfoque dio resultados estables, pero cada vez queda más en el pasado. Las redes neuronales pueden analizar no solo palabras clave, sino la intención del usuario. Por ejemplo, antes aún se podía orientar a consultas como «Apartamento para familia en Los Ángeles», adaptar páginas a esas keywords y captar tráfico. Sobre esto habló Oleg Shestakov en una serie de podcasts sobre el SEO moderno.
Con la IA, las consultas de los usuarios se parecen cada vez más a prompts, cambiando esa misma búsqueda a una formulación como «Encuentra una buena vivienda en Los Ángeles para una familia de tres personas, que esté cerca del metro y de un jardín de infancia con grupo preparatorio». Encontrar un sitio que siquiera se acerque a cubrir esa consulta es casi imposible. Esto obliga a los especialistas en SEO a profundizar más en la intención del lead y pensar qué debe cubrir el artículo para satisfacerla.
WordPress y Tilda ya no son imprescindibles. Durante mucho tiempo, ambas CMS fueron consideradas el «estándar de oro» en la optimización para buscadores. Para trabajar a volumen, incluso había que contratar freelancers aparte y gastar dinero en ello.
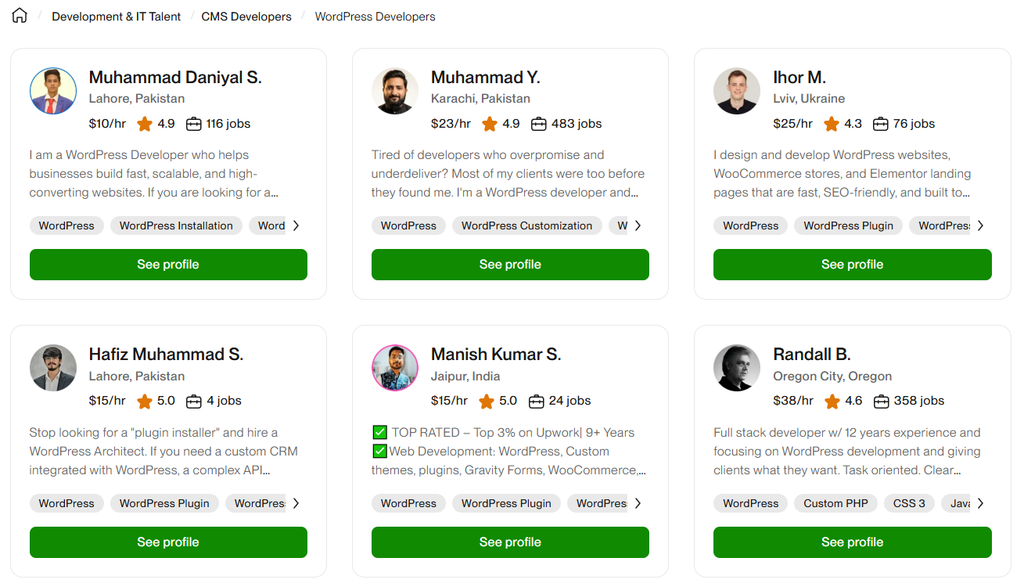
Pero este enfoque consumía mucho tiempo y energía: podías gastar un mes entero en un nicho que en realidad no tenía futuro. En cambio, con una herramienta como Claude, la creación de landings y la prueba de hipótesis se puede poner en flujo, reduciendo el tiempo de testeo a solo unos días.
Para entender cómo funciona la búsqueda con IA, daremos una breve explicación. Antes, los algoritmos analizaban palabras clave: si el usuario buscaba un coche, los resultados mostraban sitios donde esas palabras aparecían con mayor frecuencia. Se creía que esto aumentaba la probabilidad de resolver la necesidad del usuario.
La búsqueda con IA funciona de otra manera. Toma la consulta y la convierte en un embedding: un vector numérico que refleja el significado del texto. Este vector se puede imaginar como un punto en el espacio. Luego, el sistema compara ese embedding con los embeddings de otros textos, por ejemplo, páginas, párrafos y documentos. La similitud entre ellos se determina por el ángulo entre los vectores: cuanto menor es, más cercanos son los significados.
Esta idea es clave para construir una máquina SEO, porque bajo el mismo principio se pueden analizar competidores y entender qué temas y entidades realmente se relacionan con la consulta y cuáles son irrelevantes.
Qué incluye una máquina SEO basada en IA
Actualmente, un especialista en SEO puede montar su propia cadena para analizar resultados y competidores, crear textos, maquetar sitios y publicarlos. La estructura detallada de la máquina SEO la veremos más adelante, pero por ahora aclaremos el concepto general:
- Research. Análisis de resultados, competidores e intención. En esta etapa se determina qué necesita el usuario y qué páginas ya cubren esa consulta;
- Outline. Formación de la estructura del artículo o página. Aquí se define la lógica del material: qué bloques habrá, qué preguntas se deben abordar y en qué orden;
- Textos. Generación y edición de contenido. La IA escribe un borrador, luego pasa por revisión, edición y optimización para la intención específica;
- Plantillas. Creación de estructuras universales de páginas. Esto permite no construir cada página desde cero, sino escalar soluciones ya probadas;
- Publicación. Etapa final, donde las páginas se ensamblan y publican automáticamente en la red, generalmente a través de soluciones en la nube y sin CMS adicionales.
Ahora pasemos a la construcción de la máquina SEO y al análisis detallado de cada etapa.
Cómo automatizar el SEO de forma eficaz con redes neuronales
La tarea principal del media buyer en la etapa de construcción de la máquina SEO es crear un sistema eficiente adaptado a sus propios objetivos y recursos. Ambas variables son diferentes para cada uno, así que nos centraremos en la funcionalidad básica a un coste razonable.
La primera vez recomendamos pasar por este algoritmo manualmente para entender qué resultado exigirle a la red neuronal. Luego, el proceso se puede automatizar.
Construyendo el sistema de research
Lo primero es construir el sistema de análisis. Consta de dos capas: creación de tablas y recopilación de fuentes. Primero necesitamos registrar los datos y luego recolectar la mayor cantidad de información posible de los resultados, competidores y plataformas relacionadas.
Cómo crear una tabla. De inmediato aclaramos que cada especialista en SEO decide por sí mismo cómo se verá su tabla. Para mayor comodidad, te ofrecemos esta opción, creada en un par de minutos en ChatGPT.
Cómo recopilar fuentes. Ahora hay que entender dónde se encuentran los intents que necesitamos. Para ello, tomamos la consulta principal y vamos a Google. El objetivo principal en esta etapa no es solo abrir varios sitios, sino comprender cómo el propio motor de búsqueda desglosa el tema y qué subintenciones identifica. Para esto:
- Primero recopilamos los resultados básicos. Abrimos los primeros 10–20 sitios y los anotamos en la tabla. Es necesario registrar no solo la URL, sino también el tipo de página, la estructura y el enfoque general para desarrollar el tema;
- Luego profundizamos el análisis con “La gente también pregunta”. Aquí seleccionamos 5–10 preguntas, que copiamos tal cual. Estas ya son formulaciones listas de intents directamente de Google;
- Después analizamos la parte inferior de la primera página. Esto complementa la visión y permite ver direcciones relacionadas que también están conectadas con el tema principal;
- El siguiente paso es añadir fuentes adicionales. Usando la búsqueda site:reddit.com analizamos discusiones y preguntas reales de usuarios. Paralelamente, abrimos videos relevantes en YouTube y anotamos los temas, problemas y formulaciones que se repiten. Para ahorrar tiempo, puedes descargar los subtítulos con un servicio especial.
Si el afiliado ya tiene un sitio rentable, analizamos por separado los datos de Google Search Console. De ahí hay que tomar las consultas reales que ya generan impresiones y clics. Como resultado, obtenemos no solo una lista de enlaces, sino un conjunto completo de intents, preguntas y direcciones dentro del tema. Luego, todo esto se puede automatizar usando parsers, exportando texto en bruto y su análisis semántico con IA.
Después de esto, hay que estructurar los datos obtenidos. Aquí es importante no complicar la estructura, pero sí mantener la lógica. En la hoja SERP de la tabla, cada fila corresponde a una página individual. Allí anotamos la consulta, URL, título, tipo de página y una breve descripción del contenido. En la página Questions cada fila está dedicada a una pregunta específica. En esta hoja indicamos la formulación, la fuente, la pertenencia al tema y una breve explicación del intent. En la hoja Competitors registramos los elementos clave de las páginas: URL, títulos, estructura (H2/H3), presencia de tablas, FAQ y otros bloques, así como puntos fuertes y débiles. En la hoja Content Map reunimos la estructura final. Cada fila contiene el tema, subtema, pregunta concreta y el formato del bloque futuro: texto, lista, tabla o FAQ.
Si después de llenar la tabla queda claro qué preguntas se repiten, qué bloques son obligatorios y dónde hay vacíos en los resultados, entonces el sistema está bien armado. Pero si solo resulta una lista de enlaces sin estructura ni conclusiones, significa que la etapa de análisis no fue de mucha calidad.
Dividimos el texto en bloques
Cuando tengas las fuentes y el mapa del tema a la vista, es necesario preparar el texto para su posterior análisis y trabajo con embeddings. Para ello, se divide en chunks: fragmentos de sentido independientes con los que el sistema trabajará como unidades separadas.
Recomendamos empezar dividiendo primero la estructura y luego los textos. Ante todo, separamos el texto en bloques lógicos: encabezados H2 y H3, párrafos, listas, FAQ y tablas. Si en un fragmento se mezclan varios significados, es necesario dividirlo.
Al crear un chunk, es importante que tenga un tamaño óptimo. Debe ser lo suficientemente corto para que no se mezclen diferentes temas, pero lo bastante largo para mantener el contexto. En la práctica, recomendamos lo siguiente: un chunk = un párrafo, subapartado o respuesta a una pregunta. Si una sección es demasiado larga, la dividimos en varias partes, procurando no separar tablas, listas ni estructuras lógicas relacionadas.
Cada chunk se registra junto con su contexto: se indica el encabezado al que pertenece, el orden dentro del documento y la fuente. Esto es necesario para que, en el análisis posterior, no solo se puedan encontrar fragmentos similares, sino también entender de dónde provienen y qué papel juegan en el texto. Como resultado, se obtiene un conjunto de fragmentos limpios y estructurados, donde cada chunk representa una unidad de significado independiente.
Elegimos modelos para crear embeddings
Cuando tenemos los chunks, hay que convertirlos en embeddings. Esto es necesario para que la IA trabaje no con palabras, sino con los vectores que le son familiares. De esto depende directamente la precisión con la que el sistema encontrará coincidencias semánticas y comparará el contenido.
La elección del modelo para crear embeddings no es universal. Principalmente depende de las tareas, el volumen de datos y los requisitos de calidad. Por experiencia, podemos recomendar tres opciones:
- text-embedding-3-small de OpenAI. Opción óptima para empezar y para tareas masivas. Ofrece buena calidad a bajo costo, procesa grandes volúmenes de texto rápidamente y es adecuada para la mayoría de tareas SEO: clustering, búsqueda de chunks similares y análisis de competidores;
- text-embedding-3-large de OpenAI. Lo usamos cuando se requiere máxima precisión y ya se tiene una base analítica. Capta mejor las conexiones semánticas complejas, es ideal para análisis profundo de intentos, nichos complejos y clustering semántico preciso. Pero tiene una desventaja: mayor coste y carga.
- all-MiniLM-L6-v2. Buena opción para trabajo local y minimizar costes. Funciona rápido, no requiere pago de API y es adecuado para pruebas, MVP y proyectos pequeños. Sin embargo, su calidad es inferior a modelos más avanzados, especialmente en textos complejos, pero es la opción más económica.
Para mayor comodidad, hemos preparado una pequeña tabla que te ayudará a entender rápidamente cuándo y qué modelo utilizar.
Importante: si empezamos a trabajar con un modelo, debemos continuar con él hasta el final del proyecto. Cada modelo genera embeddings a su manera. Esto significa que all-Mini no entenderá los embeddings de text-embedding-3.
Creamos el outline
Una vez que se han recopilado las fuentes y preparado los chunks, se puede pasar a armar el outline, es decir, la estructura del futuro contenido. Esta no es una etapa creativa, sino un trabajo mecánico basado en los datos obtenidos previamente. En este paso, nuestra tarea es tomar todos los intents encontrados y organizarlos en una secuencia lógica.
Para estructurar correctamente el outline, tomamos la tabla con las preguntas y el mapa del tema, y agrupamos todas las preguntas por sentido. Luego destacamos de 3 a 6 grandes clústeres: estos serán los futuros H2. Por ejemplo, si el tema es sobre cimientos para una casa, los bloques separados serán elección del tipo, errores, costo, preparación del terreno, etc.
Ahora, dentro de cada clúster, desglosamos las preguntas en subpuntos. Aquí es importante no solo enumerar todo, sino establecer un orden: de lo simple a lo complejo. Primero va la explicación, luego los detalles, y después los casos particulares y excepciones. Estos subpuntos se convierten en H3.
Después de esto, revisamos la estructura en busca de duplicados. A menudo sucede que la misma pregunta aparece con diferentes formulaciones: estos elementos se combinan en un solo bloque. Si no se hace esto, el texto quedará inflado y perderá el enfoque. Si la etapa está completa, definimos el formato de cada bloque. Esto no se hace al azar, sino según los resultados de búsqueda y el intent. Cuando los competidores usan tablas en todas partes, significa que el usuario espera una comparación. Pero si en los resultados hay FAQ, hay que añadir un bloque de preguntas.
El penúltimo paso es comprobar la cobertura. Para ello, tomamos la lista original de preguntas y la comparamos con el outline: cada intent debe estar cubierto por un bloque separado. Si alguna pregunta no encaja en ningún sitio, la estructura está mal hecha y hay que rehacerla. Después de esto, revisamos la lógica del outline. Los bloques deben ir en una secuencia natural: primero la introducción al tema, luego lo básico, después el desarrollo y solo al final detalles adicionales y FAQ.
En la última etapa, hay que comparar el outline con el contenido que está en el top de los resultados de búsqueda. Si la estructura es más débil o cubre menos preguntas que la de los competidores, la mejoramos. Si cubre los mismos intents pero lo hace de forma más profunda o conveniente, el outline está listo. Como resultado, obtenemos no solo un plan de artículo, sino un mapa preciso del futuro contenido, basado en datos reales de búsqueda y comportamiento de usuarios.
Escribimos los textos y los revisamos
Después de armar el outline, comenzamos la generación del texto. Es importante entender que la IA no debe escribir el artículo completo de una sola vez: esto hace que se pierda la estructura, aparezcan repeticiones y se rompa la lógica. Es más correcto trabajar por chunks, donde cada bloque del outline (H2 o H3) se genera como un fragmento independiente. Se le da una pregunta concreta, el formato del bloque y, si es necesario, los chunks de los competidores recopilados en la etapa de análisis. Así se obtiene un texto que va directo al intent necesario, sin dispersarse en el tema.
Para crear textos de manera eficiente, es recomendable usar ChatGPT y Claude juntos. Por ejemplo, ChatGPT puede armar el outline y Claude escribir el texto paso a paso en la dirección deseada. Esto cuesta literalmente centavos: por $1 se pueden generar unas 50 000 palabras en inglés. Eso son unas 80 páginas A4 en fuente 12. Pero para quienes no quieren complicarse con Claude y su consola, hay una alternativa sobre la que ya hay un caso.
Antes de generar, establecemos límites claros: volumen del bloque, estilo, nivel de detalle y formato, por ejemplo, lista, tabla o explicación. Cuanto más precisos sean los parámetros, menos correcciones necesitaremos al final. Después, hay que revisar el texto. Primero, por sentido: ¿responde el bloque a la pregunta?, ¿hay relleno o fallos lógicos? Si el bloque no cubre el intento, lo reescribimos desde cero, no solo lo corregimos.
Luego, es necesario hacer una verificación factual. Todos los datos concretos, cifras y afirmaciones deben ser comprobados, porque la red neuronal puede generar información plausible pero incorrecta. Las redes neuronales aprenden de datos de otras redes, lo que provoca un ciclo de alucinaciones.
En la última etapa, reunimos todos los fragmentos en un solo material y realizamos una revisión final rápida de coherencia: ¿el texto se lee de forma lógica?, ¿hay saltos entre bloques?, ¿no se ha perdido la línea principal de la narración? Como resultado, obtenemos no solo un texto generado, sino un material estructurado donde cada bloque cubre un intento concreto y contribuye al objetivo general de la página.
Creamos una base de plantillas
Después de que el afiliado haya trabajado con un par de materiales, notará que los mismos bloques, formatos y lógica de presentación se repiten una y otra vez. Para no construir la estructura desde cero en cada artículo, es más conveniente fijarlo en forma de una base de plantillas. Primero identificamos los elementos recurrentes: introducciones, bloques explicativos, comparaciones, listas de errores, checklists, FAQ, tablas y conclusiones. En cualquier nicho, la cantidad de estos bloques es limitada y se pueden estandarizar.
Luego, no copiamos los textos, sino que fijamos la estructura de cada plantilla: de qué partes consta, en qué orden se presenta la información y qué objetivo cumple. Por ejemplo, el bloque de comparación siempre incluye criterios, una tabla y una breve conclusión, y el bloque de errores — descripción del problema, consecuencias y solución.
De inmediato vinculamos las plantillas a los intents: elección, explicación, comparación, solución de problemas. Esto permite no solo acelerar la redacción, sino también cubrir sistemáticamente las consultas del usuario.
Después añadimos a cada plantilla 1–2 ejemplos exitosos de materiales ya escritos, para orientarnos más rápido en el trabajo. Ahora, al generar, no necesitaremos formular la tarea desde cero: basta con tomar una plantilla lista y rellenarla con el contenido necesario. Así reducimos el tiempo, disminuimos los errores y hacemos el resultado más estable.
Publicamos a través de Cloud
Cuando el texto está listo, nuestra tarea no es solo colocarlo en el sitio, sino hacerlo rápido, en masa y sin trabajo manual innecesario.
El pipeline se puede implementar mediante integración con API o herramientas de automatización: por ejemplo, n8n o un simple script que toma los datos (texto, title, description, URL) y los envía al sistema de publicación. Como resultado, pueden aparecer decenas de páginas nuevas sin intervención humana. Como solución en la nube, se suelen usar hostings estáticos y plataformas edge: Cloudflare Pages, Vercel u otros servicios similares. Permiten desplegar cambios rápidamente a un precio relativamente bajo.
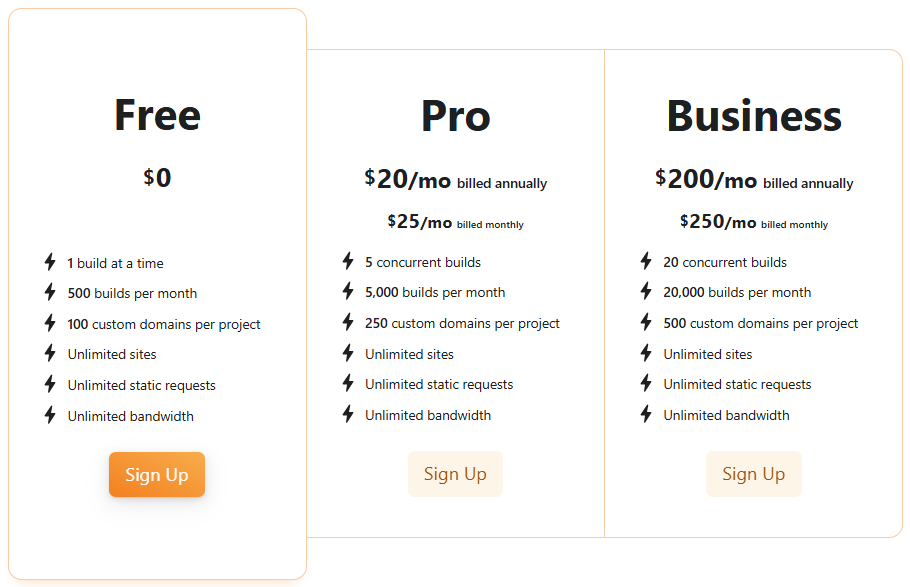
Como resultado, la publicación deja de ser un cuello de botella. En lugar de trabajo manual, aparece una línea de montaje donde las nuevas páginas se crean y publican automáticamente, y la máquina SEO empieza a funcionar como un sistema completo.
costo-seo-maquina-2026
Ahora analicemos lo más importante: cuánto costará automatizar este tipo de trabajo. Para ahorrar tiempo, hemos preparado una tabla resumen con los gastos aproximados para 100 sitios web.
La partida de gastos más grande son los dominios, pero no se puede ahorrar en ellos usando IA. Compartimos un pequeño truco: en GitHub hay una herramienta que permite reducir el costo del LLM API hasta en un 92% respecto al pago inicial. Gracias a esto, diseñar el sistema para tus tareas costará literalmente centavos.
Conclusión
El SEO en 2026 deja de ser un conjunto de acciones aisladas y se convierte en un sistema. No ganan quienes solo escriben textos o recopilan semántica, sino quienes saben construir un sistema: analizar rápidamente los resultados, estructurar datos y escalar contenido sin perder calidad.
En términos simples, una máquina SEO básica hoy se arma con elementos concretos:
- Agente de IA para investigación: integración de n8n con SerpAPI o simple scraping de resultados vía API;
- tabla para análisis en Google Sheets o Excel;
- modelo para embeddings, por ejemplo, text-embedding-3-small como opción básica o all-MiniLM-L6-v2 para trabajo local;
- red neuronal para crear el esquema, por ejemplo, ChatGPT;
- red neuronal para el texto — Claude;
- banco de plantillas: plantillas propias en Notion o Google Docs;
- publicación de sitios a través de Cloudflare Pages, Vercel u otras soluciones en la nube similares por API o n8n.
Las redes neuronales permiten automatizar tareas rutinarias, acelerar la prueba de hipótesis y trabajar con volúmenes que antes eran inaccesibles. Sin embargo, el factor clave no es la herramienta, sino el enfoque en su uso.
Como resultado, la máquina SEO se convierte no solo en una forma de obtener tráfico, sino en una herramienta completa para el crecimiento sistemático. Y cuanto antes logres construir esa infraestructura, mayor será la probabilidad de posicionarte en el nuevo modelo de búsqueda.

Comentarios (0)