

У 2026 році SEO перестало бути просто про оптимізацію сторінок для Google чи Яндекса. Щоб виходити в плюс, тепер потрібно боротися за видимість сайту в різних середовищах: Bing, ChatGPT, Аліса, AI Overviews тощо.
Багато SEO-спеціалістів думають, що нейромережі миттєво впораються з пошуковою оптимізацією. Але результат їхньої роботи сильно залежить від того, як мислить сам вебмайстер. У статті розберемося, як створити свою SEO-машину, організувати роботу ШІ і скільки приблизно це буде коштувати
Як виглядає SEO у 2026 році і чому без AI нікуди
Коли аффіліат працював лише по Google чи Яндексу, працювати було значно простіше: є кейси, нотатки розробників і тематичні форуми. Зараз обмежуватися тільки класичним пошукачем сенсу мало. За даними на січень 2025 року більш ніж у 2/3 випадків користувачі вирішують проблему саме за допомогою AI-відповідей, а не результатів класичної видачі.
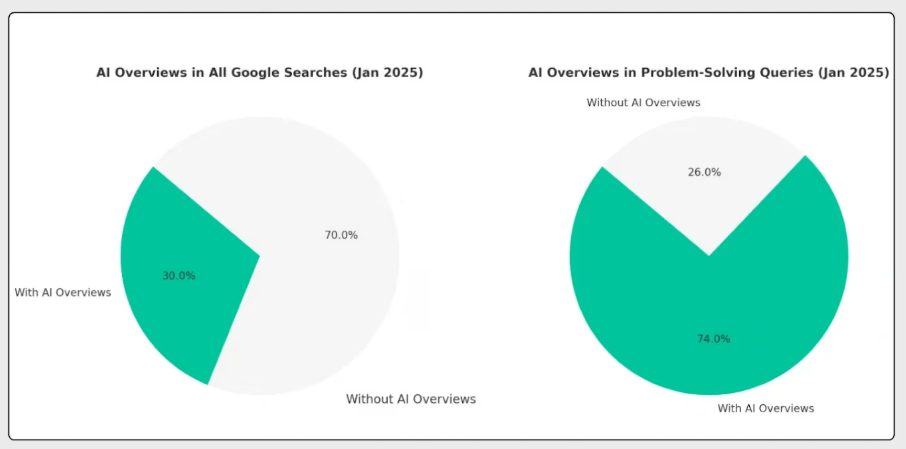
Логіка проста: навіщо вручну переглядати сотні сторінок, якщо нейромережа сама проаналізує всю інформацію і дасть структуровану відповідь краще будь-якої статті?
Така ситуація змушує SEO-фахівців переосмислити підхід до роботи і тримати в голові мінімум три важливі деталі:
Користувачі шукають інформацію всюди. Раніше пошук був максимально лінійним: юзер йшов у Google чи Яндекс, вводив короткий запит, відкривав пару сайтів і шукав там відповідь. По суті, вся боротьба йшла тільки за позиції у видачі. Але зараз така модель вже не підходить для роботи. Користувач може задати питання в ChatGPT і одразу отримати готову відповідь без переходу на сайт, а може піти на YouTube і подивитися відео. Крім цього, частина лідів обов’язково скористається голосовим асистентом і вирішить свою проблему в zero-click.
Ключі більше не в пріоритеті. До впровадження ШІ однією з головних задач будь-якого SEO-фахівця було детальне складання ТЗ по текстах із зазначенням кількості потрібних входжень. Багато років цей підхід стабільно давав результат, але він все більше відходить у минуле. Нейромережі можуть аналізувати не звичайні ключі, а інтенцію користувача. Наприклад, раніше ще можна було орієнтуватися на запити типу «Квартира для сім’ї в Лос-Анджелесі», адаптувати сторінки під ці ключі і збирати трафік. Про це говорив Олег Шестаков у серії подкастів про сучасне SEO.
З ШІ звернення користувачів все більше схожі на промпти, змінюючи той самий запит на формулювання типу «Знайди хороше житло в Лос-Анджелесі для сім’ї з трьох осіб, щоб поруч було метро і дитячий садок з підготовчою групою». Знайти сайт, де буде хоча б мінімальне попадання в такий запит, майже нереально. Це змушує SEO-фахівців глибше занурюватися в інтенцію ліда і продумувати, що потрібно висвітлити в статті, щоб її закрити.
WordPress і Tilda більше не must-have. Довгий час обидві CMS вважалися «золотим стандартом» у пошуковій оптимізації. Щоб взяти обсягом, доводилося навіть наймати окремих фрілансерів і витрачати на це гроші.
Але такий підхід забирав багато часу та сил: можна було витратити місяць на нішу, яка насправді безперспективна. Зате за допомогою умовного Claude створення лендів і тестування гіпотез можна поставити на потік, скоротивши час тестів до лічених днів.
Щоб зрозуміти, як працює ІІ-пошук, наведемо коротке пояснення. Раніше алгоритми аналізували ключі: якщо користувач шукає машину, то у видачі йому показували сайти, де найчастіше зустрічаються такі слова. Вважалося, що це підвищує шанс вирішення задачі користувача.
ІІ-пошук працює інакше. Він бере запит і переводить його в ембеддінг — числовий вектор, який відображає сенс тексту. Такий вектор можна уявити як точку в просторі. Далі система порівнює цей ембеддінг з ембеддінгами інших текстів, наприклад, сторінок, абзаців і документів. Схожість між ними визначається через кут між векторами: чим він менший, тим ближчі смисли.
Ця думка важлива для побудови SEO-машини, тому що за таким же принципом можна аналізувати конкурентів і розуміти, які теми та сутності дійсно близькі до запиту, а які зайві.
Що входить до SEO-машини на базі ІІ
На даний момент SEO-спеціаліст може зібрати собі власний конвеєр для аналізу видачі та конкурентів, складання текстів, верстки сайтів і їх публікації. Детальну структуру SEO-машини ми розглянемо нижче, а поки розберемося із загальною концепцією:
- Ресерч. Аналіз видачі, конкурентів та інтенції. На цьому етапі визначається, що саме потрібно користувачу і які сторінки вже закривають цей запит;
- Аутлайн. Формування структури статті чи сторінки. Тут задається логіка матеріалу: які блоки будуть, які питання потрібно розкрити і в якому порядку;
- Тексти. Генерація та доопрацювання контенту. ІІ пише чернетку, а далі вона проходить перевірку, редактуру і посилення під конкретний інтенс;
- Шаблони. Створення універсальних структур сторінок. Це дозволяє не збирати кожну сторінку з нуля, а масштабувати робочі рішення;
- Публікація. Фінальний етап, де сторінки автоматично збираються і викладаються в мережу — найчастіше через хмарні рішення і без зайвих CMS.
Тепер перейдемо до складання SEO-машини та детального розгляду кожного етапу.
Як ефективно автоматизувати SEO за допомогою нейромереж
Основне завдання арбітражника на етапі складання SEO-машини — побудувати ефективну систему під власні задачі та ресурси. Обидві змінні у всіх різні, тому орієнтуємося на базовий функціонал за адекватною ціною.
Перший раз ми рекомендуємо пройти цей алгоритм самостійно, щоб зрозуміти, якого результату вимагати від нейромережі. Далі процес можна автоматизувати.
Вибудовуємо систему ресерчу
Перше, з чого починаємо, — вибудовуємо систему аналітики. Вона складається з двох шарів: створення таблиць і збору джерел. Спочатку потрібно зафіксувати дані, а потім зібрати максимум інформації з видачі, конкурентів і суміжних платформ.
Як створити таблицю. Одразу зазначимо, що кожен SEO-спеціаліст сам вирішує, як виглядатиме його таблиця. Для зручності пропонуємо такий варіант, створений за кілька хвилин у ChatGPT.
Як збирати джерела. Тепер потрібно зрозуміти, де знаходяться потрібні нам інтенти. Для цього беремо основний запит і йдемо в Google. Головне завдання на цьому етапі — не просто відкрити кілька сайтів, а зрозуміти, як сама пошукова система структурує тему і які підінтенти вона бачить. Для цього:
- Спочатку знімаємо базову видачу. Відкриваємо перші 10–20 сайтів і заносимо в таблицю. Потрібно зафіксувати не лише URL, а й тип сторінки, структуру та загальний підхід до розкриття теми;
- Далі поглиблюємо аналіз через «Люди також шукають». Тут виписуємо 5–10 питань, які копіюємо в оригінальному вигляді. Це вже готові формулювання інтенцій від самого Google;
- Після цього аналізуємо низ першої сторінки. Вони доповнюють картину і дозволяють побачити суміжні напрямки, які також пов’язані з основною темою;
- Наступним кроком підключаємо додаткові джерела. Через пошук по site:reddit.com аналізуємо обговорення та реальні питання користувачів. Паралельно відкриваємо релевантні ролики на YouTube, з яких виписуємо повторювані теми, болі та формулювання. Щоб зекономити час, можна завантажити субтитри через спеціальний сервіс.
Якщо у арбітражника вже є прибутковий сайт, окремо аналізуємо дані з Google Search Console. Звідти потрібно взяти реальні запити, за якими вже є покази та кліки. У результаті у нас формується не просто список посилань, а повноцінний набір інтенцій, питань і напрямків всередині теми. Потім усе це можна буде автоматизувати за допомогою парсерів, вивантаження сирого тексту та його семантичного аналізу за допомогою ШІ.
Після цього потрібно структурувати отримані дані. Тут важливо не ускладнювати структуру, але при цьому зберегти логіку. На листі SERP у таблиці кожен рядок відповідає окремій сторінці. Туди записуємо запит, URL, заголовок, тип сторінки та короткий опис змісту. На сторінці Questions кожен рядок відведений під окреме питання. На цьому листі вказуємо формулювання, джерело, належність до теми та коротке пояснення інтенції. На листі Competitors заносимо ключові елементи сторінок: URL, заголовки, структура (H2/H3), наявність таблиць, FAQ та інших блоків, а також сильні і слабкі сторони. На листі Content Map збираємо фінальну структуру. Кожен рядок містить тему, підтему, конкретне питання і формат майбутнього блоку — текст, список, таблиця чи FAQ.
Якщо після заповнення таблиці стає зрозуміло, які питання повторюються, які блоки є обов’язковими і де є прогалини у видачі, то система зібрана коректно. Якщо ж вийшов просто список посилань без структури і висновків, значить етап аналітики пройшов не дуже якісно.
Розбиваємо текст на чанки
Коли перед очима будуть джерела та мапа теми, потрібно підготувати текст для подальшого аналізу та роботи з ембеддінгами. Для цього його розбивають на чанки — окремі смислові фрагменти, з якими система працюватиме як з незалежними одиницями.
Рекомендуємо спочатку розбивати структуру, а потім тексти. В першу чергу ділимо сам текст на логічні блоки: заголовки H2 і H3, абзаци, списки, FAQ і таблиці. Якщо в одному фрагменті змішано кілька смислів, його потрібно розділити.
Під час створення чанка важливо зробити його оптимальним за обсягом. Він має бути достатньо коротким, щоб у ньому не змішувалися різні теми, але й достатньо довгим, щоб зберігався контекст. На практиці радимо робити так: один чанк = один абзац, підпункт або відповідь на питання. Занадто довгі розділи розбиваємо на кілька частин, при цьому важливо не розривати таблиці, списки та зв’язані логічні конструкції.
Кожен чанк фіксуємо разом із контекстом: вказуємо заголовок, до якого він належить, порядок у документі та джерело. Це потрібно для того, щоб під час подальшого аналізу можна було не лише знаходити схожі фрагменти, а й розуміти, звідки вони взяті та яку роль відіграють у тексті. В результаті отримуємо набір чистих, структурованих фрагментів, де кожен чанк є окремою одиницею змісту.
Підбираємо моделі для створення ембеддінгів
Коли у нас є чанки, їх потрібно перевести в ембеддінги. Це необхідно для того, щоб ШІ працював не зі словами, а зі звичними для нього векторами. Від цього напряму залежить, наскільки точно система буде знаходити смислові збіги та порівнювати контент.
Вибір моделі для створення ембеддінгів не універсальний. В першу чергу він залежить від задач, обсягу даних і вимог до якості. З досвіду можемо рекомендувати три варіанти:
- text-embedding-3-small від OpenAI. Оптимальний варіант для старту та масових задач. Дає гарну якість при низькій вартості, швидко обробляє великі обсяги тексту й підходить для більшості SEO-задач: кластеризація, пошук схожих чанків і аналіз конкурентів;
- text-embedding-3-large від OpenAI. Використовуємо в тих випадках, коли важлива максимальна точність і вже напрацьована база в аналітиці. Краще вловлює складні смислові зв’язки, підходить для глибокого аналізу інтенції, складних ніш і точної семантичної кластеризації. Але є й мінус — вища вартість і навантаження.
- all-MiniLM-L6-v2. Гарний варіант для локальної роботи й мінімізації витрат. Працює швидко, не потребує оплати API й підходить для тестів, MVP і невеликих проєктів. При цьому поступається за якістю більш просунутим моделям, особливо на складних текстах, але вважається найбільш економним варіантом.
Для зручності ми зібрали невелику таблицю, яка допоможе швидко зрозуміти, коли і яку модель використовувати.
Важливо: якщо починаємо працювати з однією моделлю, то з нею й продовжуємо до кінця проєкту. Справа в тому, що кожна модель формує ембеддінги по-своєму. Це означає, що all-Mini не зрозуміє ембеддінги від text-embedding-3.
Створюємо аутлайн
Після того як зібрані джерела та підготовлені чанки, можна переходити до складання аутлайну — структури майбутнього матеріалу. Це не креативний етап, а механічна робота на основі отриманих раніше даних. На цьому етапі наше завдання — взяти всі знайдені інтенти й розкласти їх у логічній послідовності.
Щоб грамотно побудувати аутлайн, беремо таблицю з питаннями та мапу теми, і всі питання звідти групуємо за змістом. Далі виділяємо 3–6 великих кластерів — це й будуть майбутні H2. Наприклад, якщо тема про фундамент для будинку, то окремими блоками будуть вибір типу, помилки, вартість, підготовка ділянки тощо.
Тепер всередині кожного кластера питання розкладаємо на підпункти. Тут важливо не просто перелічити все підряд, а вибудувати порядок: від простого до складного. Спочатку йде пояснення, потім деталі, а далі — окремі випадки та винятки. Ці підпункти стають H3.
Після цього перевіряємо структуру на дублікати. Часто буває так, що одне й те саме питання зустрічається в різних формулюваннях — такі елементи об’єднуються в один блок. Якщо цього не зробити, текст вийде роздутим і втратить фокус. Якщо етап пройдено, визначаємо формат кожного блоку. Це робиться не навмання, а за видачею та інтенцією. Коли у конкурентів скрізь таблиці, значить, користувач очікує порівняння. Але якщо у видачі є FAQ, потрібно додати блок із питаннями.
Передостанній крок — перевірка повноти. Для цього беремо початковий список питань і звіряємо з аутлайном: кожен інтенс має бути закритий окремим блоком. Якщо якесь питання нікуди вставити, значить, структура зібрана неправильно і її треба переробити. Після цього перевіряємо аутлайн на логіку. Блоки мають йти у природній послідовності: спочатку вступ у тему, потім базові речі, далі — поглиблення і лише після цього — додаткові деталі та FAQ.
На останньому етапі потрібно порівняти аутлайн із контентом, який знаходиться в топі видачі. Якщо структура слабша або охоплює менше питань, ніж у конкурентів, доопрацьовуємо. Якщо ж вона закриває ті самі інтенти, але робить це глибше чи зручніше, аутлайн готовий. У результаті виходить не просто план статті, а точна карта майбутнього контенту, зібрана на основі реальних даних із пошуку та поведінки користувачів.
Пишемо тексти та перевіряємо їх
Після складання аутлайну починаємо генерацію тексту. Важливо розуміти, що нейромережа не повинна писати статтю цілком за один раз: через це втрачається структура, з’являються повтори й ламається логіка. Грамотніше організувати роботу по чанках, де кожен блок аутлайну (H2 чи H3) генерується як самостійний фрагмент. На вхід даємо конкретне питання, формат блоку й за потреби — чанки конкурентів, зібрані на етапі аналізу. Так отримуємо текст, який одразу потрапляє в потрібний інтенс, а не розмазується по темі.
Щоб ефективно створювати тексти, бажано використовувати ChatGPT і Claude разом. Наприклад, ChatGPT буде збирати аутлайн, а Claude — поетапно писати текст у потрібному ключі. Це коштує буквально копійки: за $1 можна створити близько 50 000 англійських слів. Це приблизно 80 сторінок А4 12 шрифтом. Але для тих, хто не хоче розбиратися з Claude і його консоллю, є альтернативний варіант, про який вже є кейс.
Перед генерацією задаємо чіткі обмеження: обсяг блоку, стиль, рівень деталізації та формат, наприклад, список, таблиця чи пояснення. Чим точніше задаємо параметри, тим менше правок потрібно на виході. Після цього текст треба перевірити. Спочатку за змістом: чи відповідає блок на питання, чи немає води та логічних провалів. Якщо блок не закриває інтенцію, переписуємо його, а не правимо поверх.
Далі потрібно провести фактологічну перевірку. Усі конкретні дані, цифри та твердження перевіряємо, бо нейромережа може згенерувати правдоподібну, але хибну інформацію. Нейромережі навчаються на даних від інших нейромереж, що запускає галюцинації по колу.
На останньому етапі збираємо всі чанки в єдиний матеріал і проводимо швидку фінальну перевірку на зв’язність: чи логічно читається текст, чи немає стрибків між блоками і чи не втрачена основна лінія розповіді. У результаті отримуємо не просто згенерований текст, а структурований матеріал, де кожен блок закриває конкретну інтенцію і працює на загальний результат сторінки.
Збираємо базу шаблонів
Після того як афіліат відпрацює кілька матеріалів, він помітить, що одні й ті ж блоки, формати та логіка подачі повторюються знову і знову. Щоб не збирати структуру заново для кожної статті, зручніше зафіксувати це у вигляді бази шаблонів. Спочатку виділяємо повторювані елементи: вступи, пояснювальні блоки, порівняння, списки помилок, чек-листи, FAQ, таблиці та висновки. У будь-якій ніші таких блоків обмежена кількість, і їх можна стандартизувати.
Далі не копіюємо тексти, а фіксуємо каркас кожного шаблону: з яких частин він складається, у якому порядку подається інформація і яке завдання вирішує. Наприклад, блок порівняння завжди включає критерії, таблицю і короткий висновок, а блок з помилками — опис проблеми, наслідки та рішення.
Одразу прив’язуємо шаблони до інтенцій: вибір, пояснення, порівняння, вирішення проблеми. Це дозволяє не просто прискорити написання, а й системно закривати запити користувача.
Після цього додаємо до кожного шаблону 1–2 вдалих приклади з уже написаних матеріалів, щоб швидше орієнтуватися під час роботи. Тепер при генерації не потрібно прописувати завдання з нуля: достатньо взяти готовий шаблон і підставити в нього потрібний зміст. Таким чином ми скоротимо час, зменшимо кількість помилок і зробимо результат більш стабільним.
Публікуємо через Cloud
Після того як текст готовий, наше завдання — не просто розмістити його на сайті, а зробити це швидко, масово і без зайвої ручної роботи.
Пайплайн можна реалізувати через зв’язку з API або інструментами автоматизації: наприклад, n8n чи простим скриптом, який бере дані (текст, title, description, URL) і надсилає їх у систему публікації. У результаті нові сторінки можуть з’являтися десятками без участі людини. Як хмарні рішення найчастіше використовуються статичні хостинги та edge-платформи: Cloudflare Pages, Vercel чи аналогічні сервіси. Вони дозволяють швидко викочувати зміни за відносно низькою ціною.
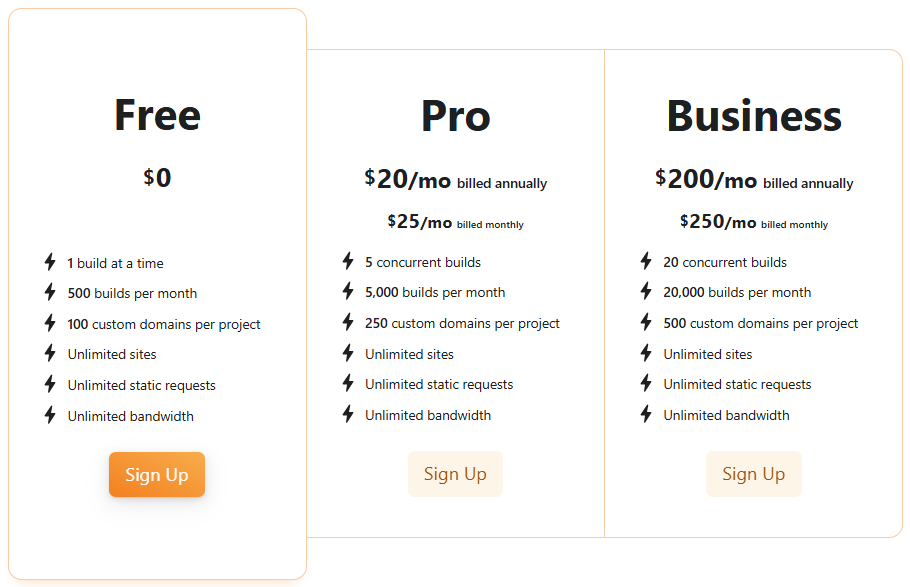
У результаті публікація перестає бути вузьким місцем. Замість ручної роботи з’являється конвеєр, де нові сторінки створюються і викочуються автоматично, а SEO-машина починає працювати як повноцінна система.
Скільки коштує SEO-машина у 2026 році
Тепер розглянемо найголовніше — скільки коштуватиме автоматизація такої роботи. Щоб не витрачати час, ми зібрали зведену таблицю приблизних витрат на 100 сайтів.
Найбільша стаття витрат — домени, але заощадити на них за рахунок ШІ не вийде. Поділимося невеликим лайфхаком: на GitHub є інструмент, який дозволяє скоротити оплату за LLM API до 92% від початкової суми. Завдяки цьому проєктування системи під свої задачі обійдеться буквально в копійки.
Висновок
SEO у 2026 році перестає бути набором розрізнених дій і перетворюється на систему. Виграють не ті, хто пише тексти чи збирає семантику, а ті, хто вміє будувати систему: швидко аналізувати видачу, структурувати дані й масштабувати контент без втрати якості.
Якщо спростити, базова SEO-машина сьогодні складається з конкретних елементів:
- ШІ-агент для ресерчу: зв’язка n8n із SerpAPI або простий парсинг видачі через API;
- таблиця для аналітики в Google Sheets або Excel;
- модель для ембеддінгів, наприклад, text-embedding-3-small як базовий варіант або all-MiniLM-L6-v2 для локальної роботи;
- нейромережа для складання аутлайну, наприклад, ChatGPT;
- нейромережа для тексту — Claude;
- база шаблонів: власні шаблони в Notion або Google Docs;
- публікація сайтів через Cloudflare Pages, Vercel або аналогічні хмарні рішення по API чи n8n.
Нейромережі дозволяють автоматизувати рутину, прискорити тестування гіпотез і працювати з обсягами, які раніше були недоступні. При цьому ключовим фактором залишається не інструмент, а підхід до його використання.
У результаті SEO-машина стає не просто способом отримання трафіку, а повноцінним інструментом для системного зростання. І чим раніше вдасться вибудувати таку інфраструктуру, тим вищий шанс зайняти позиції в новій моделі пошуку.

Коментарі (0)