

Em 2026, o SEO deixou de ser apenas sobre otimizar páginas para Google ou Yandex. Para ter lucro, agora é preciso disputar a visibilidade do site em diferentes ambientes: Bing, ChatGPT, Alice, AI Overviews e outros.
Muitos especialistas em SEO acham que as redes neurais vão resolver a otimização de busca num piscar de olhos. Mas o resultado depende muito da mentalidade do próprio webmaster. Neste artigo, vamos analisar como criar sua própria máquina de SEO, organizar o trabalho da IA e quanto isso deve custar aproximadamente.
Como é o SEO em 2026 e por que não dá para ficar sem IA
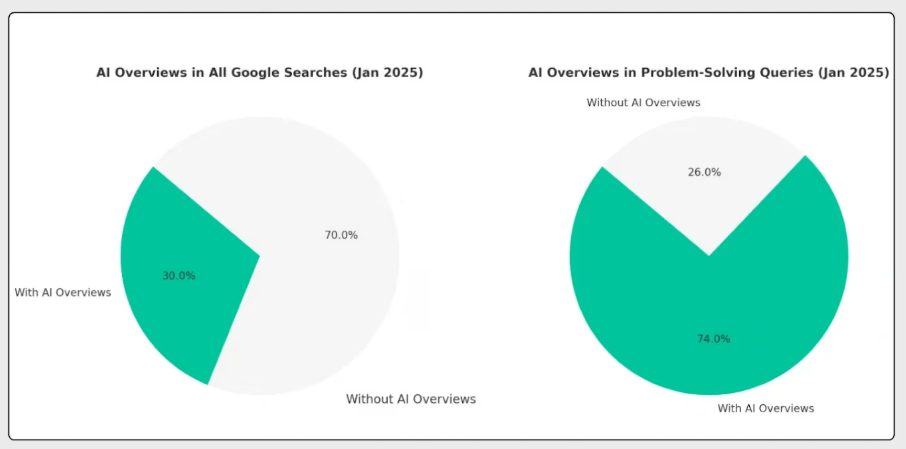
Quando o afiliado trabalhava só com Google ou Yandex, tudo era bem mais simples: havia cases, notas de desenvolvedores e fóruns temáticos. Hoje, limitar-se apenas ao buscador clássico não faz mais sentido. Segundo dados de janeiro de 2025, em mais de 2/3 dos casos os usuários resolvem seus problemas justamente com respostas de IA, e não com os resultados tradicionais.
A lógica é simples: por que vasculhar centenas de páginas manualmente se a IA pode analisar tudo e entregar uma resposta estruturada melhor que qualquer artigo?
Esse cenário faz os profissionais de SEO repensarem sua abordagem e manterem em mente pelo menos três pontos importantes:
Os usuários buscam informação em todo lugar. Antes, a busca era totalmente linear: o usuário ia ao Google ou Yandex, digitava uma consulta curta, abria alguns sites e procurava a resposta. Basicamente, toda a disputa era só por posições no ranking. Agora, esse modelo não serve mais. O usuário pode perguntar ao ChatGPT e receber a resposta pronta sem nem acessar um site, ou pode ir ao YouTube ver um vídeo. Além disso, parte dos leads certamente vai usar um assistente de voz e resolver o problema em zero-click.
Palavras-chave não são mais prioridade. Antes da IA, uma das principais tarefas de qualquer profissional de SEO era montar um briefing detalhado para os textos, indicando o número de repetições necessárias. Por muitos anos, essa abordagem trouxe resultados consistentes, mas está cada vez mais ultrapassada. As redes neurais conseguem analisar não apenas palavras-chave comuns, mas o intento do usuário. Por exemplo, antes ainda era possível focar em buscas como “Apartamento para família em Los Angeles”, adaptar páginas para essas palavras e captar tráfego. Foi sobre isso que Oleg Shestakov falou em uma série de podcasts sobre SEO moderno.
Com IA, as consultas dos usuários cada vez mais se parecem com prompts, mudando a mesma busca para algo como “Encontre uma boa moradia em Los Angeles para uma família de três pessoas, perto do metrô e de uma creche com turma preparatória”. Encontrar um site que atenda minimamente a esse pedido é quase impossível. Isso obriga os profissionais de SEO a mergulhar mais fundo no intento do lead e pensar no que precisa ser abordado no artigo para atender essa demanda.
WordPress e Tilda não são mais indispensáveis. Por muito tempo, ambas as CMS foram consideradas o “padrão ouro” da otimização para busca. Para ganhar em volume, era comum até contratar freelancers específicos e gastar dinheiro com isso.
Mas esse método consumia muito tempo e energia: você podia gastar um mês inteiro em um nicho que, na verdade, não tinha futuro. Já com uma ferramenta como o Claude, é possível colocar a criação de landings e o teste de hipóteses em fluxo contínuo, reduzindo o tempo de testes para apenas alguns dias.
Para entender como funciona a busca por IA, vamos dar uma breve explicação. Antes, os algoritmos analisavam palavras-chave: se o usuário procurava por um carro, os resultados exibiam sites onde essas palavras apareciam com mais frequência. Acreditava-se que isso aumentava a chance de resolver a necessidade do usuário.
A busca por IA funciona de outra forma. Ela pega a consulta e a transforma em um embedding — um vetor numérico que reflete o significado do texto. Esse vetor pode ser representado como um ponto no espaço. Em seguida, o sistema compara esse embedding com os embeddings de outros textos, como páginas, parágrafos e documentos. A semelhança entre eles é determinada pelo ângulo entre os vetores: quanto menor o ângulo, mais próximos são os significados.
Esse conceito é importante para construir uma máquina de SEO, porque o mesmo princípio pode ser usado para analisar concorrentes e entender quais temas e entidades realmente estão próximos da consulta e quais são irrelevantes.
O que inclui uma máquina de SEO baseada em IA
Atualmente, o especialista em SEO pode montar sua própria linha de produção para analisar resultados e concorrentes, criar textos, montar sites e publicá-los. A estrutura detalhada da máquina de SEO veremos a seguir, mas por enquanto vamos entender o conceito geral:
- Pesquisa. Análise dos resultados, concorrentes e intenção. Nesta etapa, define-se o que o usuário realmente precisa e quais páginas já atendem a essa demanda;
- Outline. Estruturação do artigo ou página. Aqui se define a lógica do material: quais blocos haverá, quais perguntas precisam ser respondidas e em que ordem;
- Textos. Geração e aprimoramento do conteúdo. A IA escreve um rascunho, que depois passa por revisão, edição e otimização para a intenção específica;
- Templates. Criação de estruturas universais de páginas. Isso permite não montar cada página do zero, mas escalar soluções já testadas;
- Publicação. Etapa final, onde as páginas são montadas automaticamente e publicadas na web — geralmente via soluções em nuvem e sem CMS desnecessárias.
Agora vamos passar para a montagem da máquina de SEO e analisar cada etapa em detalhes.
Como automatizar o SEO de forma eficiente com IA
A principal tarefa do afiliado na montagem da máquina de SEO é construir um sistema eficiente para suas próprias necessidades e recursos. Cada um tem variáveis diferentes, então vamos focar no funcional básico por um preço acessível.
Recomendamos passar por esse algoritmo manualmente na primeira vez, para entender qual resultado exigir da IA. Depois, o processo pode ser automatizado.
Montando o sistema de pesquisa
O primeiro passo é montar o sistema de análise. Ele tem duas camadas: criação de tabelas e coleta de fontes. Primeiro, precisamos registrar os dados e depois reunir o máximo de informações dos resultados, concorrentes e plataformas relacionadas.
Como criar uma tabela. Desde já, cada especialista em SEO decide como será a aparência da sua tabela. Para facilitar, sugerimos esta opção, criada em poucos minutos no ChatGPT.
Como coletar fontes. Agora é preciso entender onde estão os intents que buscamos. Para isso, pegamos a palavra-chave principal e vamos ao Google. O objetivo principal nesta etapa não é apenas abrir alguns sites, mas entender como o próprio mecanismo de busca organiza o tema e quais subintents ele identifica. Para isso:
- Primeiro, coletamos os resultados básicos. Abrimos os 10–20 primeiros sites e registramos na tabela. É importante anotar não só a URL, mas também o tipo de página, a estrutura e a abordagem geral do tema;
- Depois, aprofundamos a análise com o “As pessoas também perguntam”. Aqui, listamos 5–10 perguntas, copiando-as exatamente como aparecem. São formulações prontas de intents fornecidas pelo próprio Google;
- Em seguida, analisamos o final da primeira página. Esses resultados complementam o panorama e permitem identificar áreas relacionadas que também têm ligação com o tema principal;
- O próximo passo é adicionar fontes extras. Usando a busca por site:reddit.com, analisamos discussões e perguntas reais dos usuários. Paralelamente, abrimos vídeos relevantes no YouTube e anotamos temas recorrentes, dores e formulações. Para economizar tempo, é possível baixar as legendas usando um serviço específico.
Se o afiliado já possui um site monetizado, analisamos separadamente os dados do Google Search Console. De lá, extraímos as consultas reais que já geram impressões e cliques. Assim, formamos não apenas uma lista de links, mas um conjunto completo de intents, perguntas e direções dentro do tema. Depois, tudo isso pode ser automatizado com parsers, exportação de texto bruto e análise semântica via IA.
Depois disso, é preciso estruturar os dados coletados. O importante aqui é não complicar a estrutura, mas manter a lógica. Na aba SERP da tabela, cada linha corresponde a uma página separada. Ali registramos a consulta, URL, título, tipo de página e uma breve descrição do conteúdo. Na página Questions, cada linha é dedicada a uma pergunta. Nessa aba, indicamos a formulação, fonte, relação com o tema e uma breve explicação do intent. Na aba Competitors, registramos os principais elementos das páginas: URL, títulos, estrutura (H2/H3), presença de tabelas, FAQ e outros blocos, além dos pontos fortes e fracos. Na aba Content Map, reunimos a estrutura final. Cada linha contém o tema, subtema, pergunta específica e o formato do bloco futuro — texto, lista, tabela ou FAQ.
Se, após preencher a tabela, fica claro quais perguntas se repetem, quais blocos são obrigatórios e onde há lacunas nos resultados, então o sistema está montado corretamente. Se, por outro lado, ficou apenas uma lista de links sem estrutura e conclusões, significa que a etapa de análise não foi feita com qualidade.
Dividindo o texto em blocos
Quando você já tiver as fontes e o mapa do tema à mão, é hora de preparar o texto para análise e trabalho com embeddings. Para isso, o texto é dividido em chunks — fragmentos de sentido separados, com os quais o sistema irá trabalhar como unidades independentes.
Recomendamos começar dividindo primeiro a estrutura e depois os textos. Em primeiro lugar, separe o texto em blocos lógicos: títulos H2 e H3, parágrafos, listas, FAQ e tabelas. Se um fragmento mistura vários sentidos, ele deve ser separado.
Ao criar um chunk, é importante que ele seja otimizado em tamanho. Deve ser curto o suficiente para não misturar temas diferentes, mas longo o bastante para manter o contexto. Na prática, recomendamos: um chunk = um parágrafo, subitem ou resposta a uma pergunta. Seções muito longas devem ser divididas em várias partes, mas é importante não separar tabelas, listas e estruturas lógicas conectadas. Para verificar a qualidade do chunk, sugerimos uma pequena tabela:
Cada chunk deve ser registrado junto com o contexto: indique o título ao qual pertence, a ordem dentro do documento e a fonte. Isso é necessário para que, durante a análise, seja possível não só encontrar fragmentos semelhantes, mas também entender de onde vieram e qual o papel desempenham no texto. O resultado é um conjunto de fragmentos limpos e estruturados, onde cada chunk representa uma unidade de sentido separada.
Selecionando modelos para criar embeddings
Quando já temos os chunks, precisamos convertê-los em embeddings. Isso é necessário para que a IA trabalhe não com palavras, mas com vetores familiares para ela. Dessa escolha depende diretamente o quão precisamente o sistema irá encontrar correspondências de sentido e comparar conteúdos.
A escolha do modelo para criar embeddings não é universal. Em primeiro lugar, depende das tarefas, do volume de dados e dos requisitos de qualidade. Pela nossa experiência, recomendamos três opções:
- text-embedding-3-small da OpenAI. Opção ideal para começar e para tarefas em massa. Oferece boa qualidade a baixo custo, processa grandes volumes de texto rapidamente e é adequada para a maioria das tarefas de SEO: clusterização, busca de chunks semelhantes e análise de concorrentes;
- text-embedding-3-large da OpenAI. Usado quando a máxima precisão é importante e já existe uma base analítica consolidada. Capta melhor relações semânticas complexas, adequado para análise profunda de intent, nichos difíceis e clusterização semântica precisa. Mas tem um ponto negativo — custo e carga mais altos.
- all-MiniLM-L6-v2. Boa opção para trabalho local e redução de custos. Funciona rápido, não exige pagamento de API e é adequado para testes, MVP e projetos pequenos. Porém, perde em qualidade para modelos mais avançados, especialmente em textos complexos, mas é considerado a opção mais econômica.
Para facilitar, montamos uma pequena tabela que ajuda a entender rapidamente quando e qual modelo usar.
Importante: se começar a trabalhar com um modelo, continue com ele até o final do projeto. Isso porque cada modelo gera embeddings de forma diferente. Ou seja, o all-Mini não entende embeddings do text-embedding-3.
Criando o outline
Depois de reunir as fontes e preparar os chunks, podemos começar a montar o outline — a estrutura do futuro material. Esta não é uma etapa criativa, mas sim um trabalho mecânico baseado nos dados coletados anteriormente. Nesta fase, nossa tarefa é pegar todos os intents encontrados e organizá-los em uma sequência lógica.
Para estruturar corretamente o outline, pegamos a tabela com perguntas e o mapa do tema, e agrupamos todas as perguntas por sentido. Em seguida, destacamos de 3 a 6 grandes clusters — estes serão os futuros H2. Por exemplo, se o tema for fundação para casa, os blocos separados serão escolha do tipo, erros, custo, preparação do terreno e assim por diante.
Agora, dentro de cada cluster, organizamos as perguntas em subtópicos. Aqui é importante não apenas listar tudo, mas definir a ordem: do simples ao complexo. Primeiro vem a explicação, depois os detalhes, e por fim casos específicos e exceções. Esses subtópicos se tornam H3.
Depois disso, verificamos a estrutura para evitar duplicidades. Muitas vezes, a mesma pergunta aparece em diferentes formulações — esses elementos são unidos em um só bloco. Se não fizer isso, o texto ficará inflado e perderá o foco. Se a etapa estiver concluída, definimos o formato de cada bloco. Isso não é feito no achismo, mas sim com base nos resultados de busca e no intent. Quando os concorrentes usam tabelas, significa que o usuário espera uma comparação. Mas se houver FAQ nos resultados, é preciso adicionar um bloco de perguntas.
O penúltimo passo é verificar a completude. Para isso, pegamos a lista original de perguntas e conferimos com o outline: cada intent deve ser coberto por um bloco separado. Se alguma pergunta não se encaixar, a estrutura está errada e precisa ser refeita. Depois disso, revisamos o outline quanto à lógica. Os blocos devem seguir uma sequência natural: primeiro a introdução ao tema, depois os conceitos básicos, em seguida o aprofundamento e só então detalhes adicionais e FAQ.
Na última etapa, é preciso comparar o outline com o conteúdo que está no topo dos resultados de busca. Se a estrutura for mais fraca ou cobrir menos perguntas que os concorrentes, é necessário aprimorar. Mas se ela cobre os mesmos intents, porém de forma mais profunda ou conveniente, o outline está pronto. O resultado não é apenas um plano de artigo, mas um mapa preciso do conteúdo futuro, baseado em dados reais de busca e comportamento dos usuários.
Escrevendo e revisando os textos
Após montar o outline, começamos a geração do texto. É importante entender que a IA não deve escrever o artigo inteiro de uma vez: isso faz com que a estrutura se perca, surjam repetições e a lógica se quebre. O ideal é trabalhar por chunks, onde cada bloco do outline (H2 ou H3) é gerado como um fragmento independente. Fornecemos uma pergunta específica, o formato do bloco e, se necessário, os chunks dos concorrentes coletados na etapa de análise. Assim, obtemos um texto que atende diretamente ao intent desejado, sem se dispersar pelo tema.
Para criar textos de forma eficiente, é recomendável usar ChatGPT e Claude juntos. Por exemplo, o ChatGPT pode montar o outline, enquanto o Claude escreve o texto passo a passo no tom certo. Isso custa literalmente centavos: por $1 é possível criar cerca de 50.000 palavras em inglês. Isso equivale a aproximadamente 80 páginas A4 em fonte 12. Mas para quem não quer lidar com o Claude e seu console, existe uma alternativa, sobre a qual já existe um case.
Antes de gerar, definimos limites claros: volume do bloco, estilo, nível de detalhamento e formato, como lista, tabela ou explicação. Quanto mais precisos forem os parâmetros, menos ajustes serão necessários depois. Em seguida, é preciso revisar o texto. Primeiro, pelo sentido: o bloco responde à pergunta, está livre de enrolação e falhas lógicas? Se o bloco não cobre o intento, reescrevemos do zero, não apenas corrigimos por cima.
Depois, é necessário fazer uma checagem factual. Todos os dados, números e afirmações devem ser verificados, pois a IA pode gerar informações plausíveis, mas incorretas. As IAs aprendem com dados de outras IAs, o que pode gerar um ciclo de alucinações.
Na etapa final, juntamos todos os chunks em um único material e fazemos uma revisão rápida de coesão: o texto está lógico, não há saltos entre blocos e a linha principal da narrativa foi mantida? Assim, obtemos não apenas um texto gerado, mas um material estruturado, onde cada bloco cobre um intento específico e contribui para o resultado geral da página.
Criando base de templates
Depois que o afiliado produz alguns materiais, percebe que os mesmos blocos, formatos e lógica de apresentação se repetem. Para não montar a estrutura do zero a cada artigo, é melhor criar uma base de templates. Primeiro, identificamos os elementos recorrentes: introduções, blocos explicativos, comparações, listas de erros, checklists, FAQ, tabelas e conclusões. Em qualquer nicho, há um número limitado desses blocos, e eles podem ser padronizados.
Depois, não copiamos textos, mas fixamos a estrutura de cada template: de quais partes ele é composto, em que ordem a informação é apresentada e qual objetivo resolve. Por exemplo, um bloco de comparação sempre inclui critérios, tabela e uma breve conclusão, enquanto um bloco de erros traz a descrição do problema, consequências e solução.
Já vinculamos os templates aos intents: escolha, explicação, comparação, solução de problemas. Isso não só acelera a escrita, mas também garante que as demandas do usuário sejam atendidas de forma sistemática.
Depois, adicionamos a cada template 1–2 exemplos de sucesso de materiais já publicados, para facilitar a referência durante o trabalho. Assim, na geração, não será preciso criar a tarefa do zero: basta pegar o template pronto e inserir o conteúdo necessário. Dessa forma, reduzimos o tempo, minimizamos erros e tornamos o resultado mais estável.
Publicando via Cloud
Quando o texto está pronto, nossa tarefa não é apenas publicá-lo no site, mas fazer isso de forma rápida, em escala e sem trabalho manual desnecessário.
O pipeline pode ser implementado via integração com API ou ferramentas de automação: por exemplo, n8n ou um script simples que pega os dados (texto, title, description, URL) e os envia para o sistema de publicação. Assim, novas páginas podem ser publicadas aos montes sem intervenção humana. Para cloud, geralmente são usados hostings estáticos e plataformas edge: Cloudflare Pages, Vercel ou serviços similares. Eles permitem lançar mudanças rapidamente, com custo relativamente baixo.
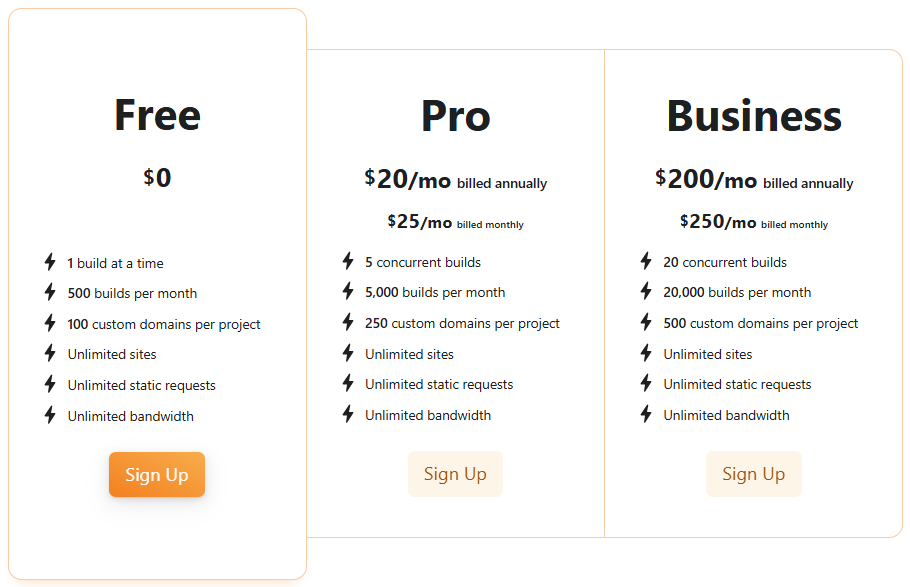
Como resultado, a publicação deixa de ser um gargalo. Em vez de trabalho manual, surge uma linha de produção, onde novas páginas são criadas e lançadas automaticamente, e a máquina de SEO começa a funcionar como um sistema completo.
custo-seo-maquina-2026
Agora vamos analisar o principal — quanto vai custar automatizar esse tipo de trabalho. Para economizar seu tempo, reunimos uma tabela resumida com os custos aproximados para 100 sites.
O maior item de despesa são os domínios, mas economizar neles usando IA não é possível. Compartilhamos um pequeno truque: no GitHub existe uma ferramenta que permite reduzir o custo da LLM API em até 92% do valor original. Assim, projetar o sistema para suas tarefas vai custar literalmente centavos.
Conclusão
O SEO em 2026 deixa de ser um conjunto de ações isoladas e se transforma em um sistema. Vencem não aqueles que apenas escrevem textos ou coletam semântica, mas quem sabe estruturar o sistema: analisar rapidamente os resultados, organizar dados e escalar conteúdo sem perder qualidade.
Resumindo, uma máquina básica de SEO hoje é composta por elementos específicos:
- Agente de IA para pesquisa: integração do n8n com SerpAPI ou simples parsing dos resultados via API;
- planilha para análise no Google Sheets ou Excel;
- modelo para embeddings, por exemplo, text-embedding-3-small como opção básica ou all-MiniLM-L6-v2 para uso local;
- rede neural para montagem de outline, como ChatGPT;
- rede neural para texto — Claude;
- banco de templates: modelos próprios no Notion ou Google Docs;
- publicação de sites via Cloudflare Pages, Vercel ou soluções em nuvem similares por API ou n8n.
As redes neurais permitem automatizar tarefas rotineiras, acelerar o teste de hipóteses e trabalhar com volumes que antes eram inacessíveis. Ainda assim, o fator chave não é a ferramenta, mas a abordagem ao utilizá-la.
Como resultado, a máquina de SEO se torna não apenas uma forma de obter tráfego, mas uma ferramenta completa para crescimento sistemático. E quanto antes você construir essa infraestrutura, maior a chance de conquistar posições no novo modelo de busca.

Comentários (0)